
Die Nachricht
Was das Modell kann
Haiku 5.5 nimmt Text und Bilder entgegen und gibt Text aus. Laut Anthropics Modelldokumentation liegt das Kontextfenster bei einer Million Tokens, die maximale Ausgabe bei 128.000 Tokens. Der Wissensstand reicht bis Juni 2026. Das adaptive Denken ist standardmäßig aktiv, der Standardaufwand steht auf „medium“. Computer Use und Browser Use gibt es als Beta.
Als Bezugswege nennt die Dokumentation die Claude API, Amazon Bedrock, Google Cloud und Microsoft Foundry. Laut Anthropics Produktseite ist Haiku 5.5 auch auf Claude.ai sowie in den Apps für iOS und Android auswählbar, für Free, Pro, Max, Team und Enterprise. Die API-Kennung lautet claude-haiku-5-5.
Der Preis
Bei Prompts bis 100.000 Tokens kostet eine Million Input-Tokens 0,10 US-Dollar, eine Million Output-Tokens 0,50 US-Dollar. Haiku 4.5 kostete noch 1 beziehungsweise 5 Dollar. Bei größeren Prompts steigen die Preise auf 0,50 und 2,50 Dollar. Wenn du mit langen Dokumenten arbeitest, rechne mit diesen höheren Preisen.
Gecachte Eingaben kosten bei Lesezugriffen noch weniger, und die Batch-Verarbeitung ist 50 Prozent günstiger. Die Preise stammen von Anthropics Preisseite und können sich ändern.
Was die Zahlen sagen
Die meisten Benchmark-Werte stammen von Anthropic selbst. Bei Terminal-Bench 4.0 erreicht Haiku 5.5 39,2 Prozent. Haiku 4.5 kam auf 0 Prozent, Sonnet 5.5 auf 70,6 Prozent. Bei GDPval-AA liegt Haiku 5.5 bei 1620 Punkten, Haiku 4.5 bei 735 und Sonnet 5.5 bei 1840. Das sind Herstellerangaben, ich habe nichts davon selbst nachgemessen.
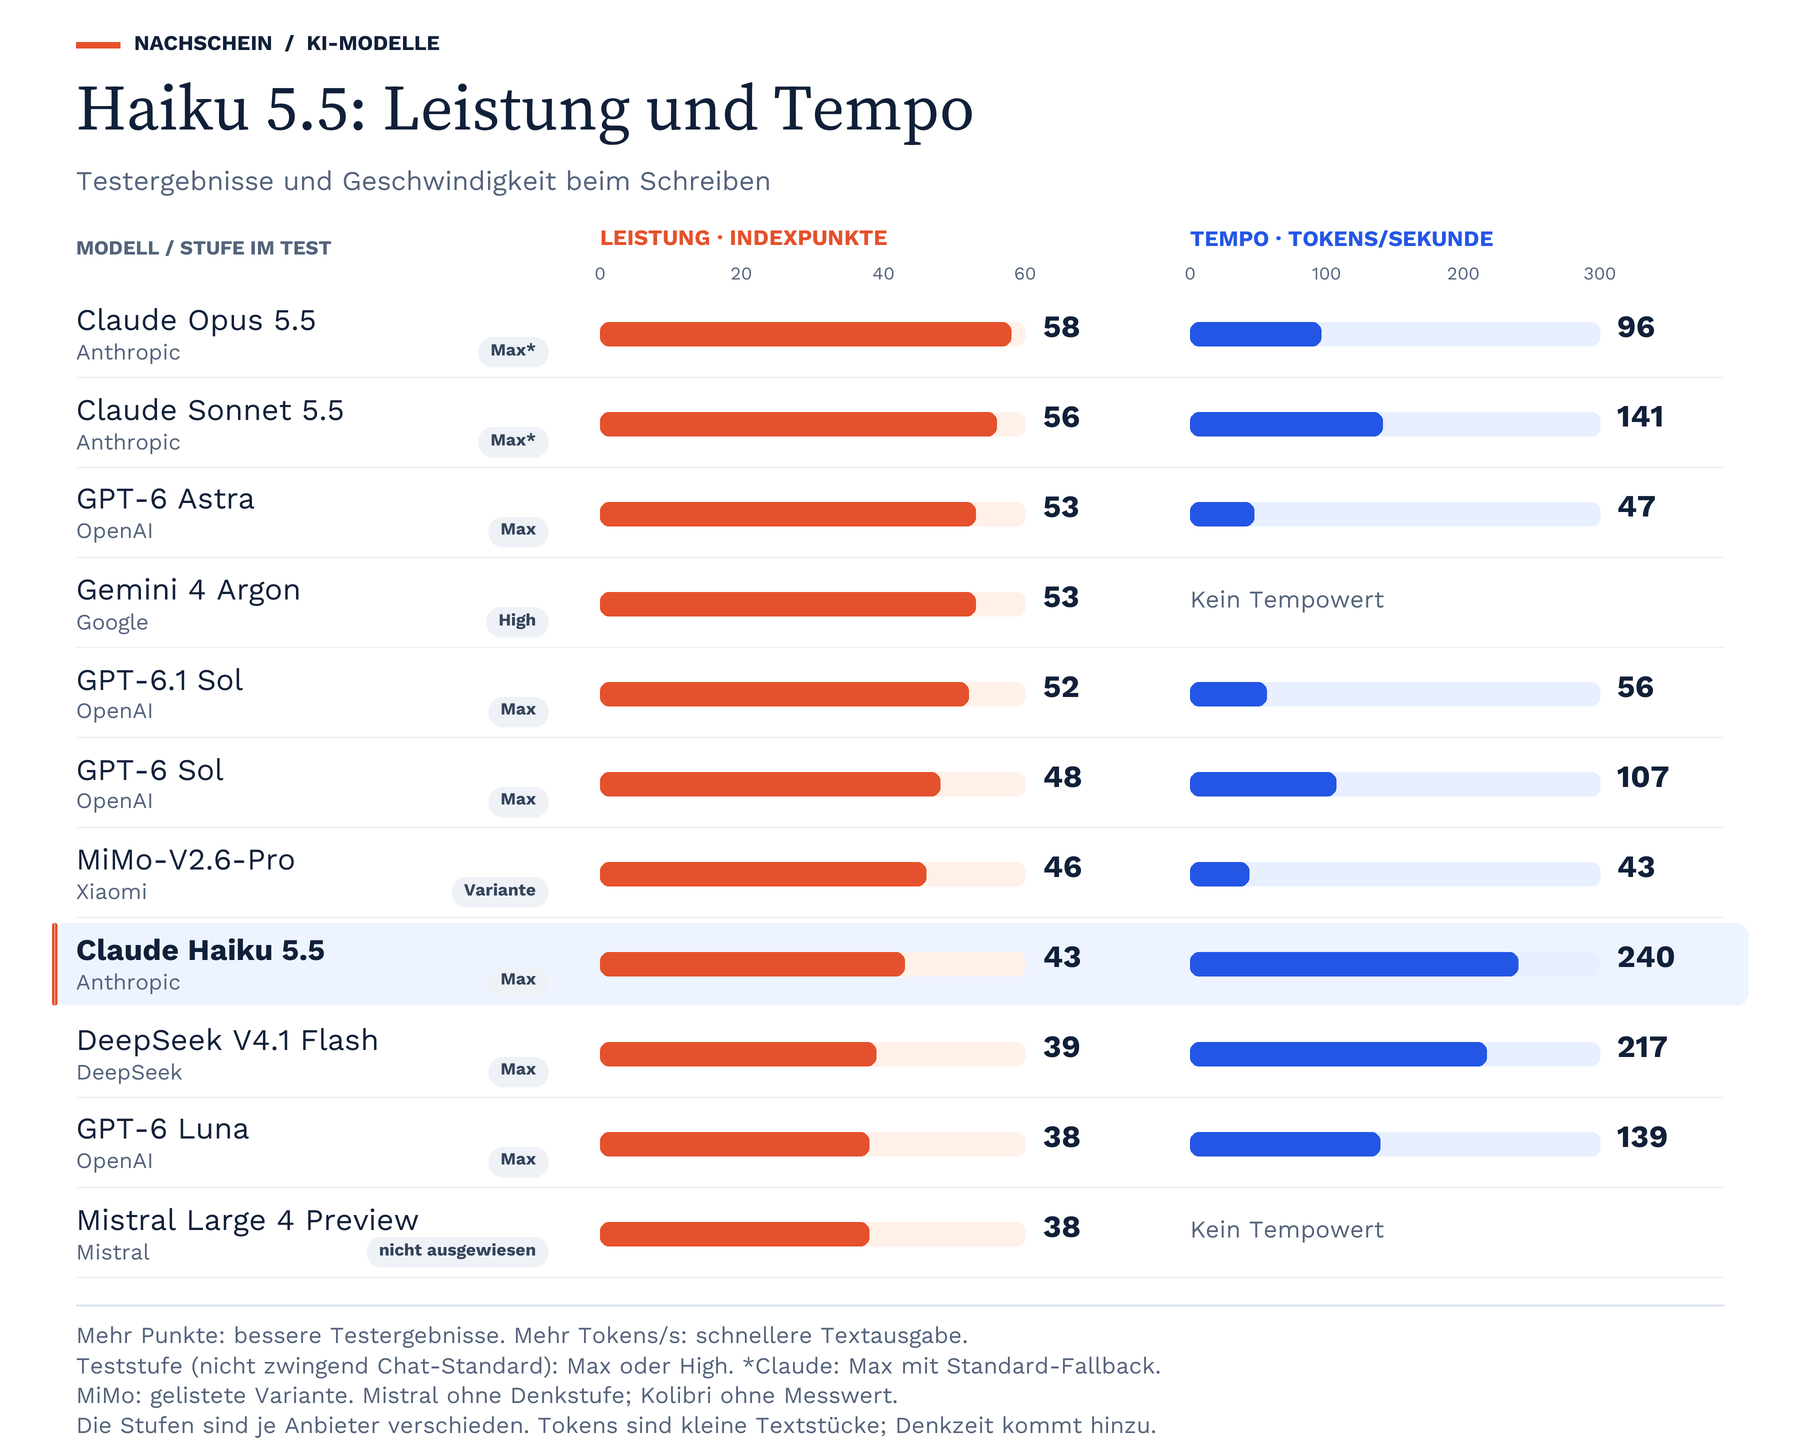
Unabhängig gemessen hat bisher vor allem Artificial Analysis. Im eigenen Intelligence Index erreicht Haiku 5.5 bei maximalem Aufwand 43 Punkte. Auffällig ist der Verbrauch. Im Index erzeugt das Modell 440 Millionen Output-Tokens, der Median der Vergleichsmodelle liegt beim Abruf am 11. Oktober 2026 bei 100 Millionen. Haiku schreibt also sehr ausführlich, und der niedrige Preis pro Token sagt wenig über die Kosten einer einzelnen Aufgabe.
Haiku 5.5 im Modellvergleich
Der naheliegende Konkurrent ist GPT-6 Luna von OpenAI, das kleine Modell der GPT-6-Reihe (mehr dazu im Beitrag zu GPT-6 Sol und Luna). Bis 100.000 Input-Tokens kosten beide 0,10 US-Dollar je Million Input-Tokens und 0,50 Dollar je Million Output-Tokens. Darüber wird Haiku fünfmal so teuer. Bei GPT-6 Luna greift die Staffel erst bei mehr als 272.000 Input-Tokens. Dann kostet die gesamte Anfrage 0,20 Dollar je Million Input-Tokens und 0,75 Dollar je Million Output-Tokens.
Artificial Analysis vergleicht beide auf maximaler Denkstufe. Haiku 5.5 erreicht 43 Punkte, GPT-6 Luna 38. Das sind Werte aus dem Intelligence Index v4.3.2, abgerufen am 11. Oktober 2026. Sie gelten für genau diese Einstellung, eine allgemeine Rangfolge für jede Aufgabe ergibt sich daraus nicht.
Bei den Kosten pro Aufgabe sieht es anders aus. Artificial Analysis nennt für Haiku auf max 0,21 Dollar, für Luna 0,07 Dollar. Im Index erzeugt Haiku 440 Millionen Output-Tokens, Luna 140 Millionen. Die Plattform rechnet mit den dort aufgeführten Tokenpreisen. Unterschiedliche Promptlängen und Preisstaffeln sind darin nicht einzeln abgebildet. Quellen: Haiku 5.5 und GPT-6 Luna.
Quellen und Messung
Quelle: Artificial Analysis: Modellrangliste, für GPT-6 Sol der Vergleich mit GPT-6 Luna. Stand: 11. Oktober 2026; Intelligence Index v4.3.2. Die Kennzeichnung nennt die im Test verwendete Stufe und ist nicht zwingend die Chat-Standardeinstellung: Max oder High. Bei Claude kennzeichnet Artificial Analysis die Stufe als Max mit Standard-Fallback. MiMo wird als gelistete Variante gezeigt; für Mistral ist keine Denkstufe ausgewiesen. Kolibri hat keinen unabhängigen Indexwert. Die Stufen sind anbieterabhängig und nicht direkt gleichzusetzen. Gemessen wird die Ausgabe über Programmierschnittstellen, nicht die Geschwindigkeit der Chatoberflächen. Die Werte können je nach Anfrage und Auslastung schwanken.
Meine Einschätzung: Auf maximaler Stufe schneidet Haiku im Benchmark besser ab als Luna, kostet pro Aufgabe aber mehr. Ob sich das für einfache Aufgaben lohnt, zeigt der Index nicht. Auch zu deutschen Briefings sagt er nichts, und unabhängige Messungen dazu habe ich nicht gefunden. Ich würde beide vorher mit eigenen Beispielen testen.
Mehr Tokens pro Aufgabe
Anthropic hat den Tokenizer aktualisiert. Die Modelldokumentation nennt für denselben Text ungefähr 30 Prozent mehr Tokens als bei Haiku 4.5. Das beschreibt die Zählweise des Textes, keine feste Mehrmenge für jede fertige Aufgabe. Simon Willison misst bei einem seiner Testprompts rund 25 Prozent mehr Tokens als bei Haiku 4.5. Ein einzelner Prompt ist keine Regel. Wenn du Kosten vergleichst, rechne den Mehrverbrauch trotzdem ein, bevor du dich bei Serienaufgaben auf ein Modell festlegst.
Was die System Card einschränkt
Die System Card nennt ein paar Schwächen. In der automatisierten Verhaltensprüfung lehnt Haiku 5.5 mehr Anfragen ab als jedes andere getestete Modell. Bei Einzelanfragen liegt die Ablehnungsquote über die API bei 0,17 Prozent. Das ist niedriger als bei Haiku 4.5, aber höher als bei Sonnet 5.5 und Opus 5.5. Außerdem halluziniert das Modell laut Anthropic mehr als andere aktuelle Modelle, ungefähr so viel wie Haiku 4.5.
Bei Prompt Injection sieht es besser aus. In einem Test mit indirekten Angriffen und bis zu 15 Angriffsversuchen nennt die System Card 83,2 Prozent Angriffserfolg für Haiku 4.5 und 7,1 Prozent für Haiku 5.5. Die Werte vergleichen zwei Modelle und zeigen nicht die Wirkung einer einzelnen Schutzmaßnahme. Gemessen wurde ohne produktive Schutzmaßnahmen, im Alltag kann das Ergebnis also anders aussehen.
Was das für KI-Videos bedeutet
Haiku 5.5 erzeugt keine Bilder und keine Videos. Nützlich ist es drumherum, zum Beispiel beim Zusammenfassen von Briefings, beim Strukturieren von Shotlisten, beim Entwerfen von Prompts für Video-Tools oder beim Sortieren von Kundenfeedback. Anthropic nennt Zusammenfassungen, Klassifikation und Subagenten als typische Einsatzfelder. Für komplexe Agenten-Workflows verweist der Hersteller auf Sonnet 5.5 und Opus 5.5.
Unabhängige Tests zu deutschen Texten oder zum Bildverständnis gibt es bisher nicht. Wenn du das Modell für deutsche Briefings nutzen willst, probier es vorher mit eigenen Beispielen aus. Die wichtigste offene Frage ist, wie viele Tokens es in der Praxis pro Aufgabe braucht. Dazu fehlen belastbare unabhängige Messungen.
Quellen
7 Links
- Anthropic: Ankündigung von Claude Haiku 5.5, 7. Oktober 2026
- Anthropic Dokumentation: Modellseite Haiku 5.5
- Anthropic Dokumentation: Preise
- Anthropic: System Card zu Claude Haiku 5.5 (PDF)
- Artificial Analysis: Messwerte zu Claude Haiku 5.5
- Artificial Analysis: Messwerte zu GPT-6 Luna
- Simon Willison: Erster Eindruck zu Claude Haiku 5.5, 7. Oktober 2026
Stand: 11. Oktober 2026, die Messwerte von Artificial Analysis habe ich am selben Tag abgerufen. Ich habe das Modell nicht selbst getestet. Preise und Verfügbarkeit können sich ändern.
Alle Angaben erfolgen nach bestem Wissen und ohne Gewähr. Für Richtigkeit, Vollständigkeit und Aktualität übernehme ich, soweit gesetzlich zulässig, keine Haftung.
Welche Aufgaben soll ein schnelles KI‑Modell in deinem Film übernehmen?
Ob erste Ideen, Varianten oder Textarbeit: Schick mir Produkt, Einsatz und Zeitraum. Du bekommst eine persönliche Einschätzung zum passenden Ablauf.