
Die Nachricht
Normale Nutzer, Entwickler und Firmen müssen warten. Google will Carbon allgemein freigeben, sobald Rückmeldungen ausgewertet und die Schutzmechanismen nachgeschärft sind. Einen Termin nennt das Unternehmen nicht. Außerdem durchläuft das Modell das freiwillige Vorabtestverfahren der US-Regierung. Google.
Wer Gemini 4 Carbon schon nutzen kann
Den Anfang machen ausgewählte Teams aus der Cyberabwehr. Danach soll der Kreis über Googles Fairwind Program schrittweise wachsen. Das Programm richtet sich an Behörden, nationale Cyberstellen und Betreiber kritischer Infrastruktur, etwa in Energie, Gesundheit oder Telekommunikation. Bewerber werden überprüft, und der Zugang darf nur an interne Sicherheitsteams gehen.
Ein Detail am Rande: Die Fairwind-Seite spricht bei meinem Abruf am 29. Oktober noch von Gemini 4 Argon, Carbon kommt dort nicht vor. Ob bisherige Partner automatisch Zugang zum neuen Modell bekommen, lässt sich damit nicht bestätigen.
Platz eins im Intelligence Index, knapp dahinter beim Programmieren
Artificial Analysis testet KI-Modelle unabhängig von den Herstellern. Im Intelligence Index v5, einer Sammlung aus neun Tests, kommt Carbon in der Denkstufe high auf 59 Punkte. Das ist ein Punkt vor Claude Opus 5.5 und neun Punkte vor dem zwei Wochen älteren Gemini 4 Argon. In vier der neun Einzeltests liegt Carbon vorn. Artificial Analysis: Auswertung vom 28. Oktober.
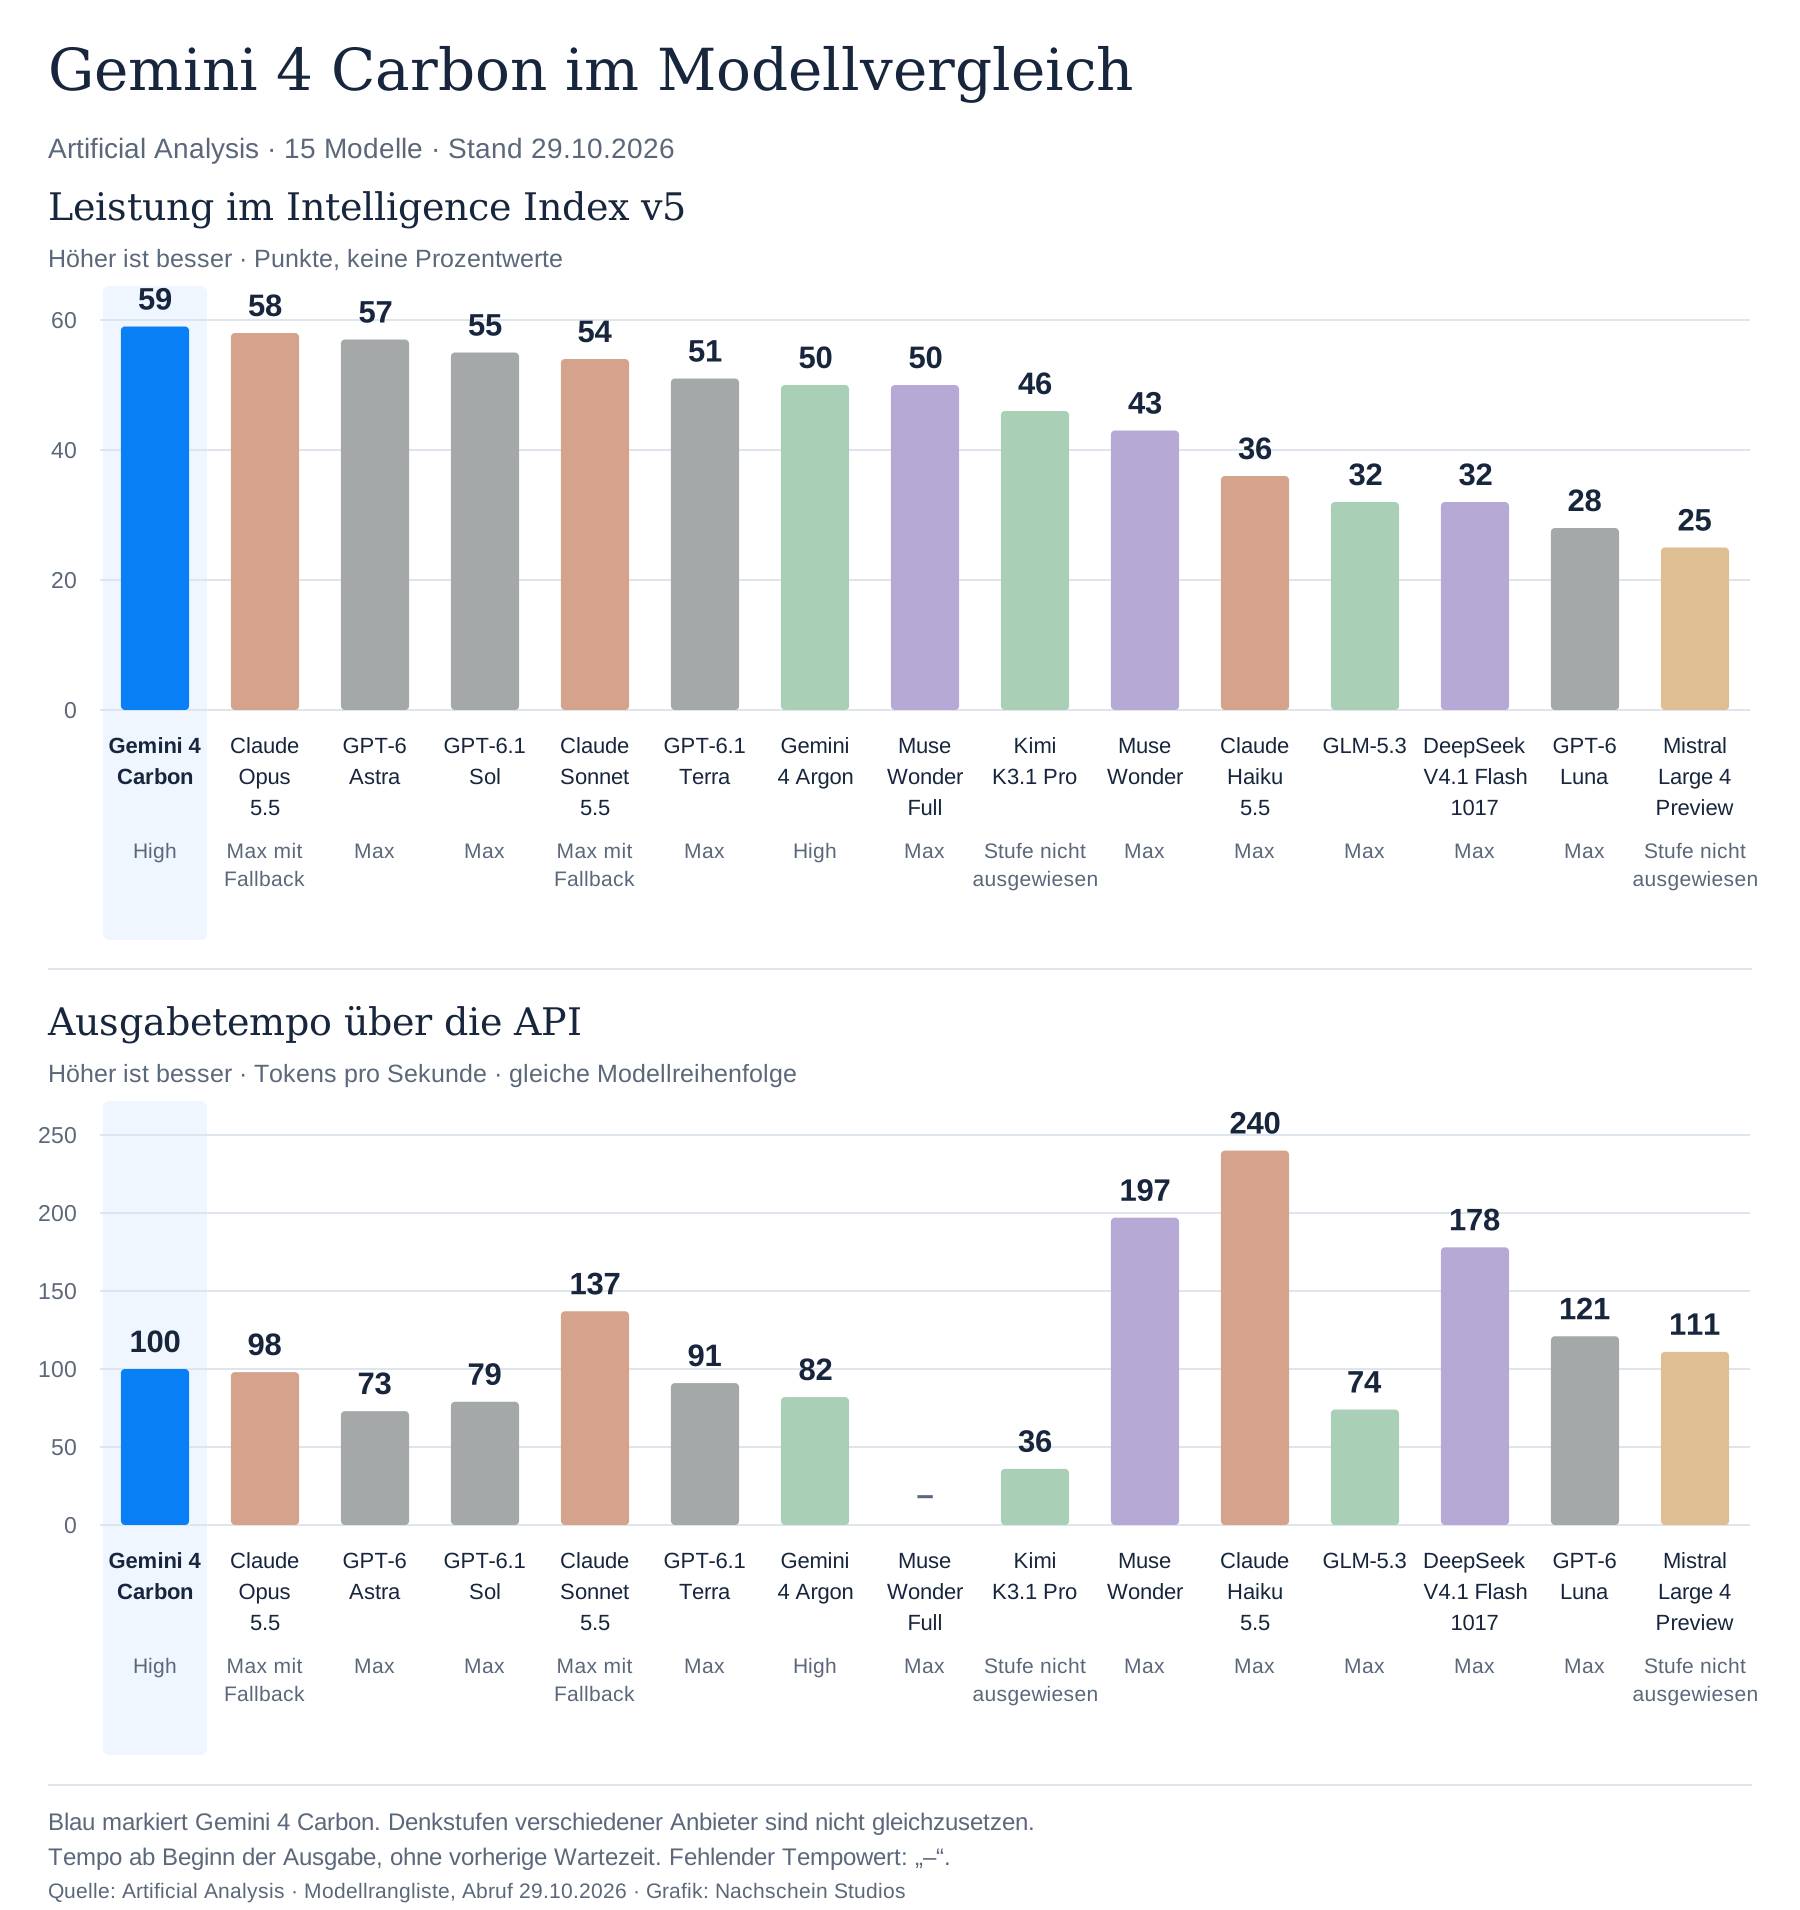
Quellen und Messung
Quelle: Artificial Analysis: Modellrangliste, Intelligence Index v5.0, Stand 29. Oktober 2026. Gezeigt wird je Modell die am besten bewertete Testvariante. Die Auswahl umfasst die großen Anbieter und mehrere offene Modelle, nicht alle gelisteten; Claude Fable 5.1 und Grok 4.7 sind nicht enthalten. Die Stufen (High, Max, „Max mit Fallback“ bei Claude) gelten für den Test und sind nicht zwingend die Standardeinstellung im Chat. Für Kimi K3.1 Pro weist Artificial Analysis keine Stufe aus, für Mistral Large 4 Preview ebenfalls nicht. Denkstufen verschiedener Anbieter sind nicht direkt gleichzusetzen. Das Tempo misst die Ausgabe über die Programmierschnittstelle, nicht im Chatfenster; die Wartezeit bis zur ersten Ausgabe kommt hinzu. Die Werte schwanken je nach Anfrage und Auslastung.
Beim Programmieren reicht es knapp nicht für die Spitze. Im Coding Agent Index kommt Carbon zusammen mit Googles Antigravity CLI auf 59 Punkte, Claude Code mit Opus 5.5 in der Stufe max auf 62. Dass Carbon dort ebenfalls 59 erreicht, ist Zufall. Der Coding Agent Index ist ein eigener Test aus drei Teilen zu Softwareentwicklung, Terminal-Arbeit und technischen Fragen und bewertet immer Modell und Werkzeug zusammen.
Google schreibt außerdem, interne Teams hätten erlebt, wie Carbon tagelang an Problemen dranbleibt und sich durch Sackgassen arbeitet. Das ist eine Beobachtung aus dem eigenen Haus. Wie oft solche langen Läufe gelingen und wie viel menschliche Hilfe sie brauchen, sagt Google nicht.
Mehr richtige Antworten, aber auch mehr erfundene
Der Wissenstest AA-Omniscience misst auch, ob ein Modell zugibt, wenn es etwas nicht weiß. Carbon beantwortet 58 Prozent der Fragen richtig, zehn Prozentpunkte mehr als Argon. Die Halluzinationsrate steigt aber von 4 auf 11 Prozent. Sie gibt an, wie oft ein Modell bei Fragen, die es nicht richtig beantworten kann, trotzdem etwas behauptet, statt zu passen. Das ist immer noch der zweitniedrigste Wert hinter Argon, Claude Opus 5.5 und GPT-6 Astra (jeweils Stufe max) liegen bei 50 Prozent. Artificial Analysis.
Sicherheitslücken schließen, finden und ausnutzen
Fürs Reparieren von Sicherheitslücken gibt es einen unabhängigen Vergleich. Im CWE-bench v1 von Collinear AI sollen die Modelle in 120 unveröffentlichten Aufgaben eine Schwachstelle im Code beheben, ohne dass vorhandene Funktionen kaputtgehen. Pro Aufgabe gibt es vier Durchläufe mit je höchstens einer Stunde Zeit, ein Programm prüft das Ergebnis automatisch.
Carbon mit Antigravity schafft im Einzelversuch 71 Prozent. Gemini 4 Argon, GPT-6 Astra und Grok 4.7 kommen auf 68 Prozent, Claude Opus 5.5 auf 67. Zählt eine Aufgabe als gelöst, sobald einer von vier Anläufen klappt, steigt Carbon auf 81 Prozent, gleichauf mit Grok 4.7. Die Modelle arbeiten dabei in unterschiedlichen Agentenumgebungen, auch das fließt ins Ergebnis ein.
Fürs Aufspüren und Ausnutzen von Lücken hat Google selbst gemessen. Im SEC-bench Pro, wo Schwachstellen gefunden werden müssen, meldet Google 88,2 Prozent. Im ExploitGym, wo das Modell eine Lücke tatsächlich ausnutzen soll, sind es 54,8 Prozent, wobei die Quelle nicht ausweist, für welches der beiden Zeitlimits der Wert gilt. Beide Tests liefen laut Google ohne die üblichen Schutzfilter. Google.
Die Evaluationsbeschreibung nennt die Bedingungen. Bei SEC-bench Pro verwendete Google 183 Aufgaben rund um JavaScript-Engines. Bei ExploitGym arbeitete Carbon in Antigravity ohne Internetzugang, gemessen einmal mit sechs und einmal mit zehn Stunden Zeit pro Aufgabe. Die Vergleichswerte der Konkurrenz stammen aus deren eigenen Berichten und wurden nicht unter gleichen Bedingungen nachgemessen. Die Zahlen zeigen, was das Modell unter Testbedingungen schafft, nicht, was ein fertiges Sicherheitsprodukt leistet.
Die Preise stehen fest, buchen kann man noch nicht
Für die Einführungsphase nennt Google 2 US-Dollar pro Million Eingabe-Tokens und 10 Dollar pro Million Ausgabe-Tokens. Danach sollen es 4 und 20 Dollar sein. Zwischengespeicherte Eingaben kosten 95 Prozent weniger. Wie lange die Einführungsphase dauert, steht nirgends.
Aufschlussreicher als der Listenpreis ist der Verbrauch. Carbon schreibt pro Aufgabe aus dem Intelligence Index 123.000 Ausgabe-Tokens, Claude Opus 5.5 in der Stufe max 173.000. Mit den regulären Preisen kostet eine Aufgabe laut Artificial Analysis 7,76 Dollar, bei Opus sind es 10,04 Dollar und bei GPT-6 Astra rund 6,25 Dollar. Artificial Analysis, Modellseite Gemini 4 Carbon. Solange Google den Zugang nicht öffnet, bleiben das Rechenbeispiele.
Quellen
9 Links
- Google: Ankündigung Gemini 4 Carbon
- Google DeepMind: Evaluationsbeschreibung
- Google DeepMind: Fairwind Program
- Artificial Analysis: Auswertung Gemini 4 Carbon
- Artificial Analysis: Modellseite Gemini 4 Carbon
- Artificial Analysis: Modellrangliste
- Artificial Analysis: Coding Agent Index
- CWE-bench v1 (Collinear AI)
- The Decoder: Rechercheausgangspunkt
Stand der Recherche: 29.10.2026.
Alle Angaben erfolgen nach bestem Wissen und ohne Gewähr. Für Richtigkeit, Vollständigkeit und Aktualität übernehme ich, soweit gesetzlich zulässig, keine Haftung.
Wie entstehen meine Artikel?
Meine Artikel beruhen auf öffentlich zugänglichen Herstellerinformationen, Fachpublikationen und weiteren angegebenen Quellen. Ich ordne Entwicklungen aus der KI-Videoproduktion und anderen KI-Bereichen ein. Eigene Praxistests kennzeichne ich ausdrücklich.