
Die Nachricht
Seit dem 6. Oktober ließ sich Large 4 als öffentliche Vorschau über Mistrals Schnittstelle ausprobieren. Die jetzt veröffentlichte Fassung hat laut Mistral drei weitere Wochen Training hinter sich, vor allem fürs Programmieren und für die Abwehr von Cyberangriffen. Dabei braucht das Modell laut Mistral auch weniger Tokens. Mistral zur Freigabe, Mistral zur Vorschau.
Was die Freigabe der Gewichte bedeutet
Die Gewichte sind das, was ein KI-Modell im Training gelernt hat, abgelegt als riesige Zahlentabellen. Wer sie herunterlädt, braucht Mistral nicht mehr als Vermittler. Das Modell läuft dann auf eigenen Rechnern und lässt sich mit eigenen Daten weitertrainieren. Für Firmen, die sensible Daten nicht an fremde Server schicken wollen, ist das oft der wichtigste Grund, sich offene Modelle anzusehen.
Laut Model Card versteht Large 4 Text und Bilder und antwortet in Text. In eine einzelne Anfrage passen rund eine Million Tokens. Tokens sind die Textbausteine, mit denen ein Modell rechnet. Wie gründlich das Modell nachdenkt, lässt sich in drei Stufen einstellen: low, medium und high.
Wer das Modell selbst betreiben kann
Am heimischen Laptop wird das nichts. Large 4 hat rund eine Billion Parameter. Pro Rechenschritt arbeitet zwar nur ein Teil davon, laut Model Card 49 Milliarden oder 52 Milliarden, wenn man die Ein- und Ausgabeschichten mitzählt. Komplett in den Speicher passen muss es trotzdem.
Die Serversoftware SGLang nennt mehrere geprüfte Aufbauten, darunter acht Nvidia-B300-Grafikkarten für die FP8-Fassung oder vier GB300 für die NVFP4-Fassung, die weniger Speicher braucht. Dazu kommen Varianten für Nvidias Vera-Rubin-Systeme. Das sind Rechenzentrumskarten. Eine Mindestanforderung ist das nicht, aber es zeigt die Größenordnung.
Wer keine eigenen Server betreiben will, kommt weiterhin über Mistrals API und Mistral Studio an das Modell, außerdem über OpenRouter, Microsoft Foundry und Angebote von Nvidia. Mistral.
Die Lizenz verlangt von Cloud-Anbietern einen eigenen Vertrag
Die Mistral Ecosystem Open-Weight License baut auf der bekannten MIT-Lizenz auf. Nutzen, verändern, weitergeben und sogar verkaufen ist erlaubt, solange der Copyright- und Lizenzhinweis erhalten bleibt.
Die Ausnahme steht in Abschnitt 2. Betreibt ein Lizenznehmer selbst oder über ein verbundenes Unternehmen ein Geschäft mit „Model as a Service“, vermietet also KI-Modelle an Dritte, muss es vor jeder kommerziellen Nutzung einen gesonderten Vertrag mit Mistral schließen. Gemeint ist der Fall, dass Kunden direkt auf das Modell zugreifen und Eingaben, Einstellungen oder Trainingsdaten selbst steuern.
Ausdrücklich frei bleiben die interne Nutzung im eigenen Haus und die Nutzung über Mistrals offizielle Produkte. Eine Anwendung, die das Modell nur für bestimmte eingebaute Funktionen verwendet, gilt laut Definition ebenfalls nicht als solcher Dienst. Dasselbe gilt fürs bloße Weiterleiten von Anfragen an Modelle, die jemand anderes betreibt. Was genau ein „verbundenes Unternehmen“ ist, definiert der Lizenztext nicht. Wer unsicher ist, fragt besser direkt bei Mistral nach.
Im Intelligence Index steht bisher nur die Vorschau
Mistrals eigene Zahlen klingen gut. Im Coding Agent Index von Artificial Analysis komme Large 4 auf 48 Punkte und liege damit praktisch gleichauf mit GLM-5.3, verbrauche pro Aufgabe aber im Schnitt 47 Prozent weniger Tokens. Im Terminal-Bench 4.0 sei der Wert gegenüber der Vorschau von 28 auf 41 Prozent gestiegen. Mistral. Der Coding Agent Index bewertet allerdings immer ein Modell zusammen mit seiner Agentensoftware, also den Werkzeugen, mit denen es Code liest und ausführt. Ein Ergebnis gilt deshalb für genau diese Kombination. Auf der Seite von Artificial Analysis konnte ich den Wert nicht nachprüfen, und welche Agentensoftware ihm zugrunde liegt, habe ich nicht bestätigen können.
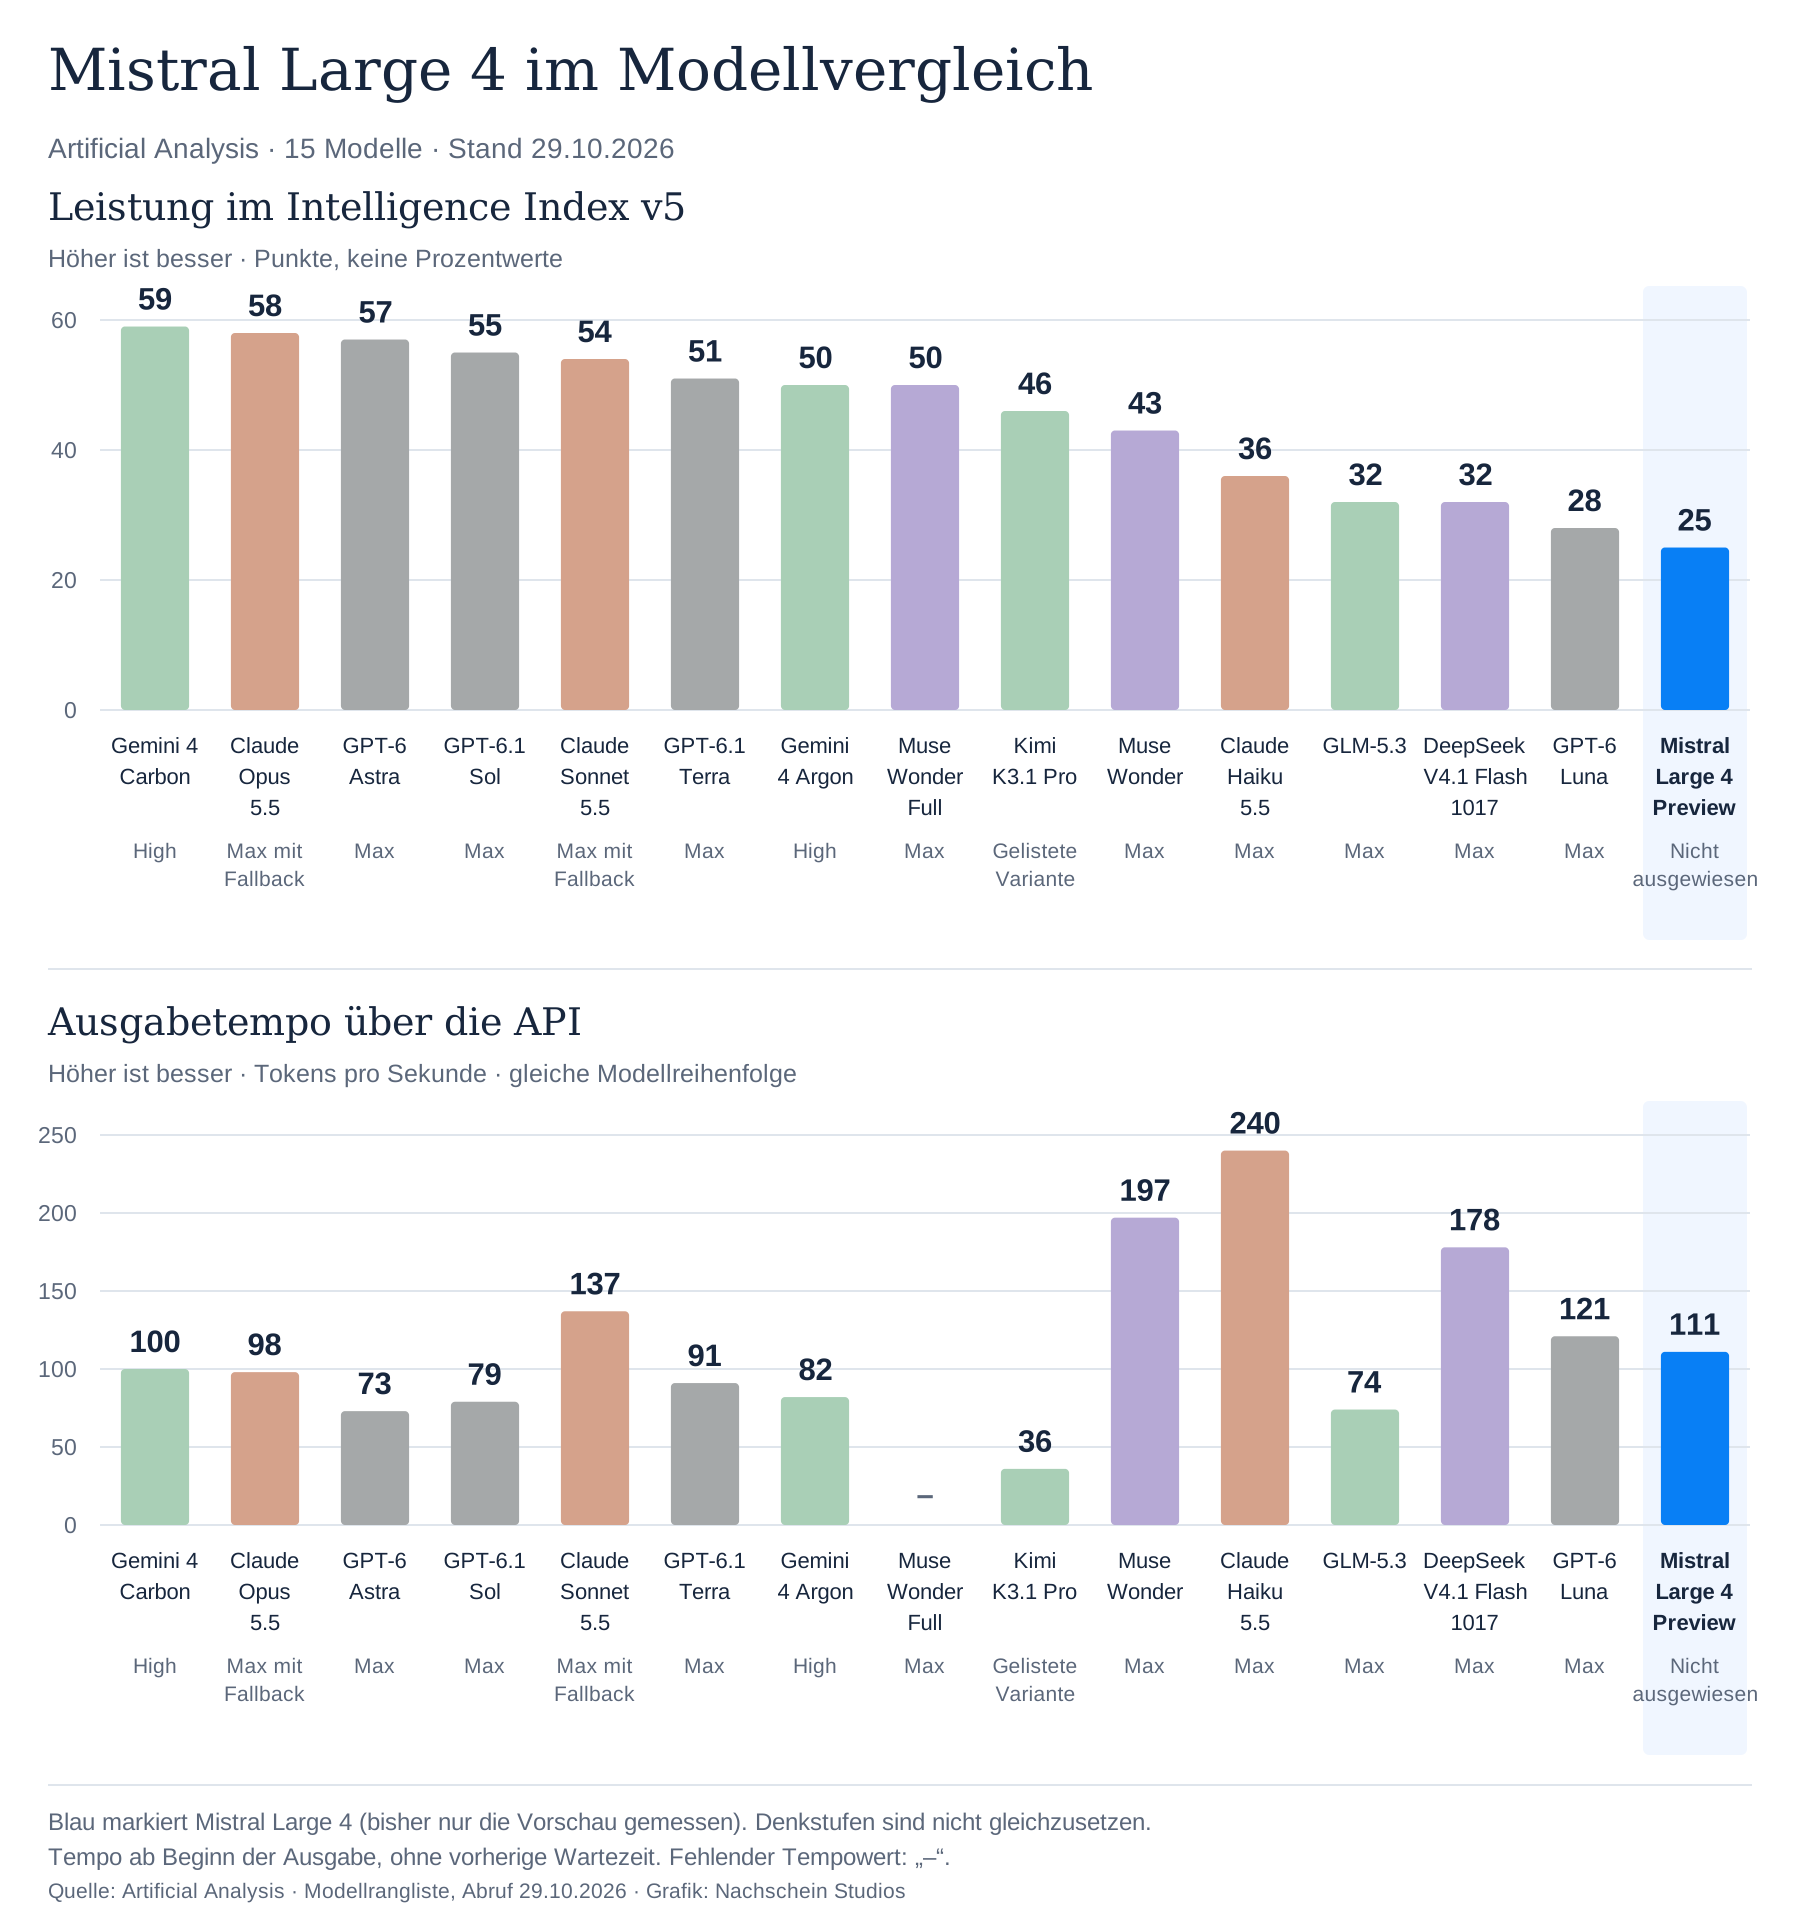
Im breiteren Intelligence Index v5 von Artificial Analysis, einer Sammlung aus neun Tests, taucht die fertige Fassung noch nicht auf (Stand 29. Oktober). Gemessen ist bisher nur die Vorschau, und die kommt auf 25 Punkte. Die offenen Modelle GLM-5.3 und DeepSeek V4.1 Flash 1017 liegen jeweils bei 32, ganz oben steht Gemini 4 Carbon mit 59. Wie viel die zusätzlichen Trainingswochen im unabhängigen Test bringen, ist damit noch offen.
Quellen und Messung
Quelle: Artificial Analysis: Modellrangliste, Intelligence Index v5.0, Stand 29. Oktober 2026. Gezeigt wird je Modell die am besten bewertete Testvariante. Die Auswahl umfasst die großen Anbieter und mehrere offene Modelle, nicht alle gelisteten; Claude Fable 5.1 und Grok 4.7 sind nicht enthalten. Die Stufen (High, Max, „Max mit Fallback“ bei Claude) gelten für den Test und sind nicht zwingend die Standardeinstellung im Chat. Für Kimi K3.1 Pro weist Artificial Analysis keine Stufe aus, für Mistral Large 4 Preview ebenfalls nicht. Denkstufen verschiedener Anbieter sind nicht direkt gleichzusetzen. Das Tempo misst die Ausgabe über die Programmierschnittstelle, nicht im Chatfenster; die Wartezeit bis zur ersten Ausgabe kommt hinzu. Die Werte schwanken je nach Anfrage und Auslastung.
Was Large 4 über die API kostet
Laut Mistrals Ankündigung kostet Large 4 0,70 US-Dollar pro Million Eingabe-Tokens, 0,07 Dollar pro Million zwischengespeicherter Eingabe-Tokens und 2,10 Dollar pro Million Ausgabe-Tokens. In Mistrals Modelldokumentation standen bei meinem Abruf am 29. Oktober noch die Vorschaupreise von 1,36 und 4,18 Dollar.
Für die Vorschau hat Artificial Analysis ausgerechnet, was eine Aufgabe aus dem Intelligence Index im Schnitt kostet: 5,54 Dollar. Bei GLM-5.3 sind es 5,01 Dollar, bei DeepSeek V4.1 Flash 1017 nur 0,60 Dollar. Diese Rechnung beruht auf den alten Vorschaupreisen und lässt sich nicht einfach auf die neue Fassung übertragen.
Wer Large 4 auf eigenen Servern betreibt, kann mit API-Preisen ohnehin wenig anfangen. Dort zählen Hardware, Strom und Auslastung. Der handfeste Gewinn der Freigabe ist die Unabhängigkeit von Mistrals Servern, sofern man die Technik dafür hat.
Quellen
12 Links
- Mistral: Freigabe der Gewichte
- Mistral: Ankündigung der Vorschau
- Hugging Face: Model Card Mistral Large 4
- Mistral Ecosystem Open-Weight License
- SGLang: geprüfte Konfigurationen
- Mistral: Modelldokumentation
- Artificial Analysis: Mistral Large 4 Preview
- Artificial Analysis: GLM-5.3
- Artificial Analysis: DeepSeek V4.1 Flash 1017
- Artificial Analysis: Modellrangliste
- Artificial Analysis: Coding Agent Index
- The Decoder: Rechercheausgangspunkt
Stand der Recherche: 29.10.2026.
Alle Angaben erfolgen nach bestem Wissen und ohne Gewähr. Für Richtigkeit, Vollständigkeit und Aktualität übernehme ich, soweit gesetzlich zulässig, keine Haftung.
Wie entstehen meine Artikel?
Meine Artikel beruhen auf öffentlich zugänglichen Herstellerinformationen, Fachpublikationen und weiteren angegebenen Quellen. Ich ordne Entwicklungen aus der KI-Videoproduktion und anderen KI-Bereichen ein. Eigene Praxistests kennzeichne ich ausdrücklich.