Die Nachricht
OpenAI hat GPT-6.1 Terra am 26. Oktober 2026 vorgestellt. Das Modell soll vor allem bei bildgestützter Arbeit und der Bedienung von Software zulegen. Die Nachricht ist zugleich eine Preissenkung: Für die Standard-API verlangt OpenAI mindestens die Hälfte weniger als beim Vorgänger GPT-5.6 Terra. Offizielle Ankündigung
Bilder verstehen und in Anwendungen arbeiten
Terra verarbeitet Text und Bilder und gibt Text aus. OpenAI nennt etwa den Abgleich von Produktfotos mit Katalogeinträgen und das Auswerten technischer Zeichnungen. Über angebundene Werkzeuge kann das Modell außerdem auf Anwendungsoberflächen arbeiten. Das ist der Unterschied zwischen einer KI, die einen Screenshot beschreibt, und einem System, das anschließend eine Aufgabe in der gezeigten Software ausführt. OpenAI-Modellbeschreibung
Für die Filmproduktion zeigt OpenAI als Testaufgabe, wie ein animierter Film Einstellung für Einstellung untersucht wird, um ein Protokoll mit Zeitmarken für eine Restaurierung zu erstellen. Das ist ein konkretes Beispiel für Arbeit am vorhandenen Material. Ankündigung und Testbeispiele
Die technische Grenze bleibt dabei wichtig: Die API-Modellseite weist Bilder als Eingabe aus, direkte Video- und Audioeingaben dagegen nicht. Wenn Terra mit Filmsoftware arbeitet, darf das deshalb nicht mit einem nativen Videomodell gleichgesetzt werden. Die verfügbaren Werkzeuge hängen vom konkreten Zugang ab. Unterstützte Ein- und Ausgaben
Mehr Leistung, aber kein Spitzenplatz im Gesamtindex
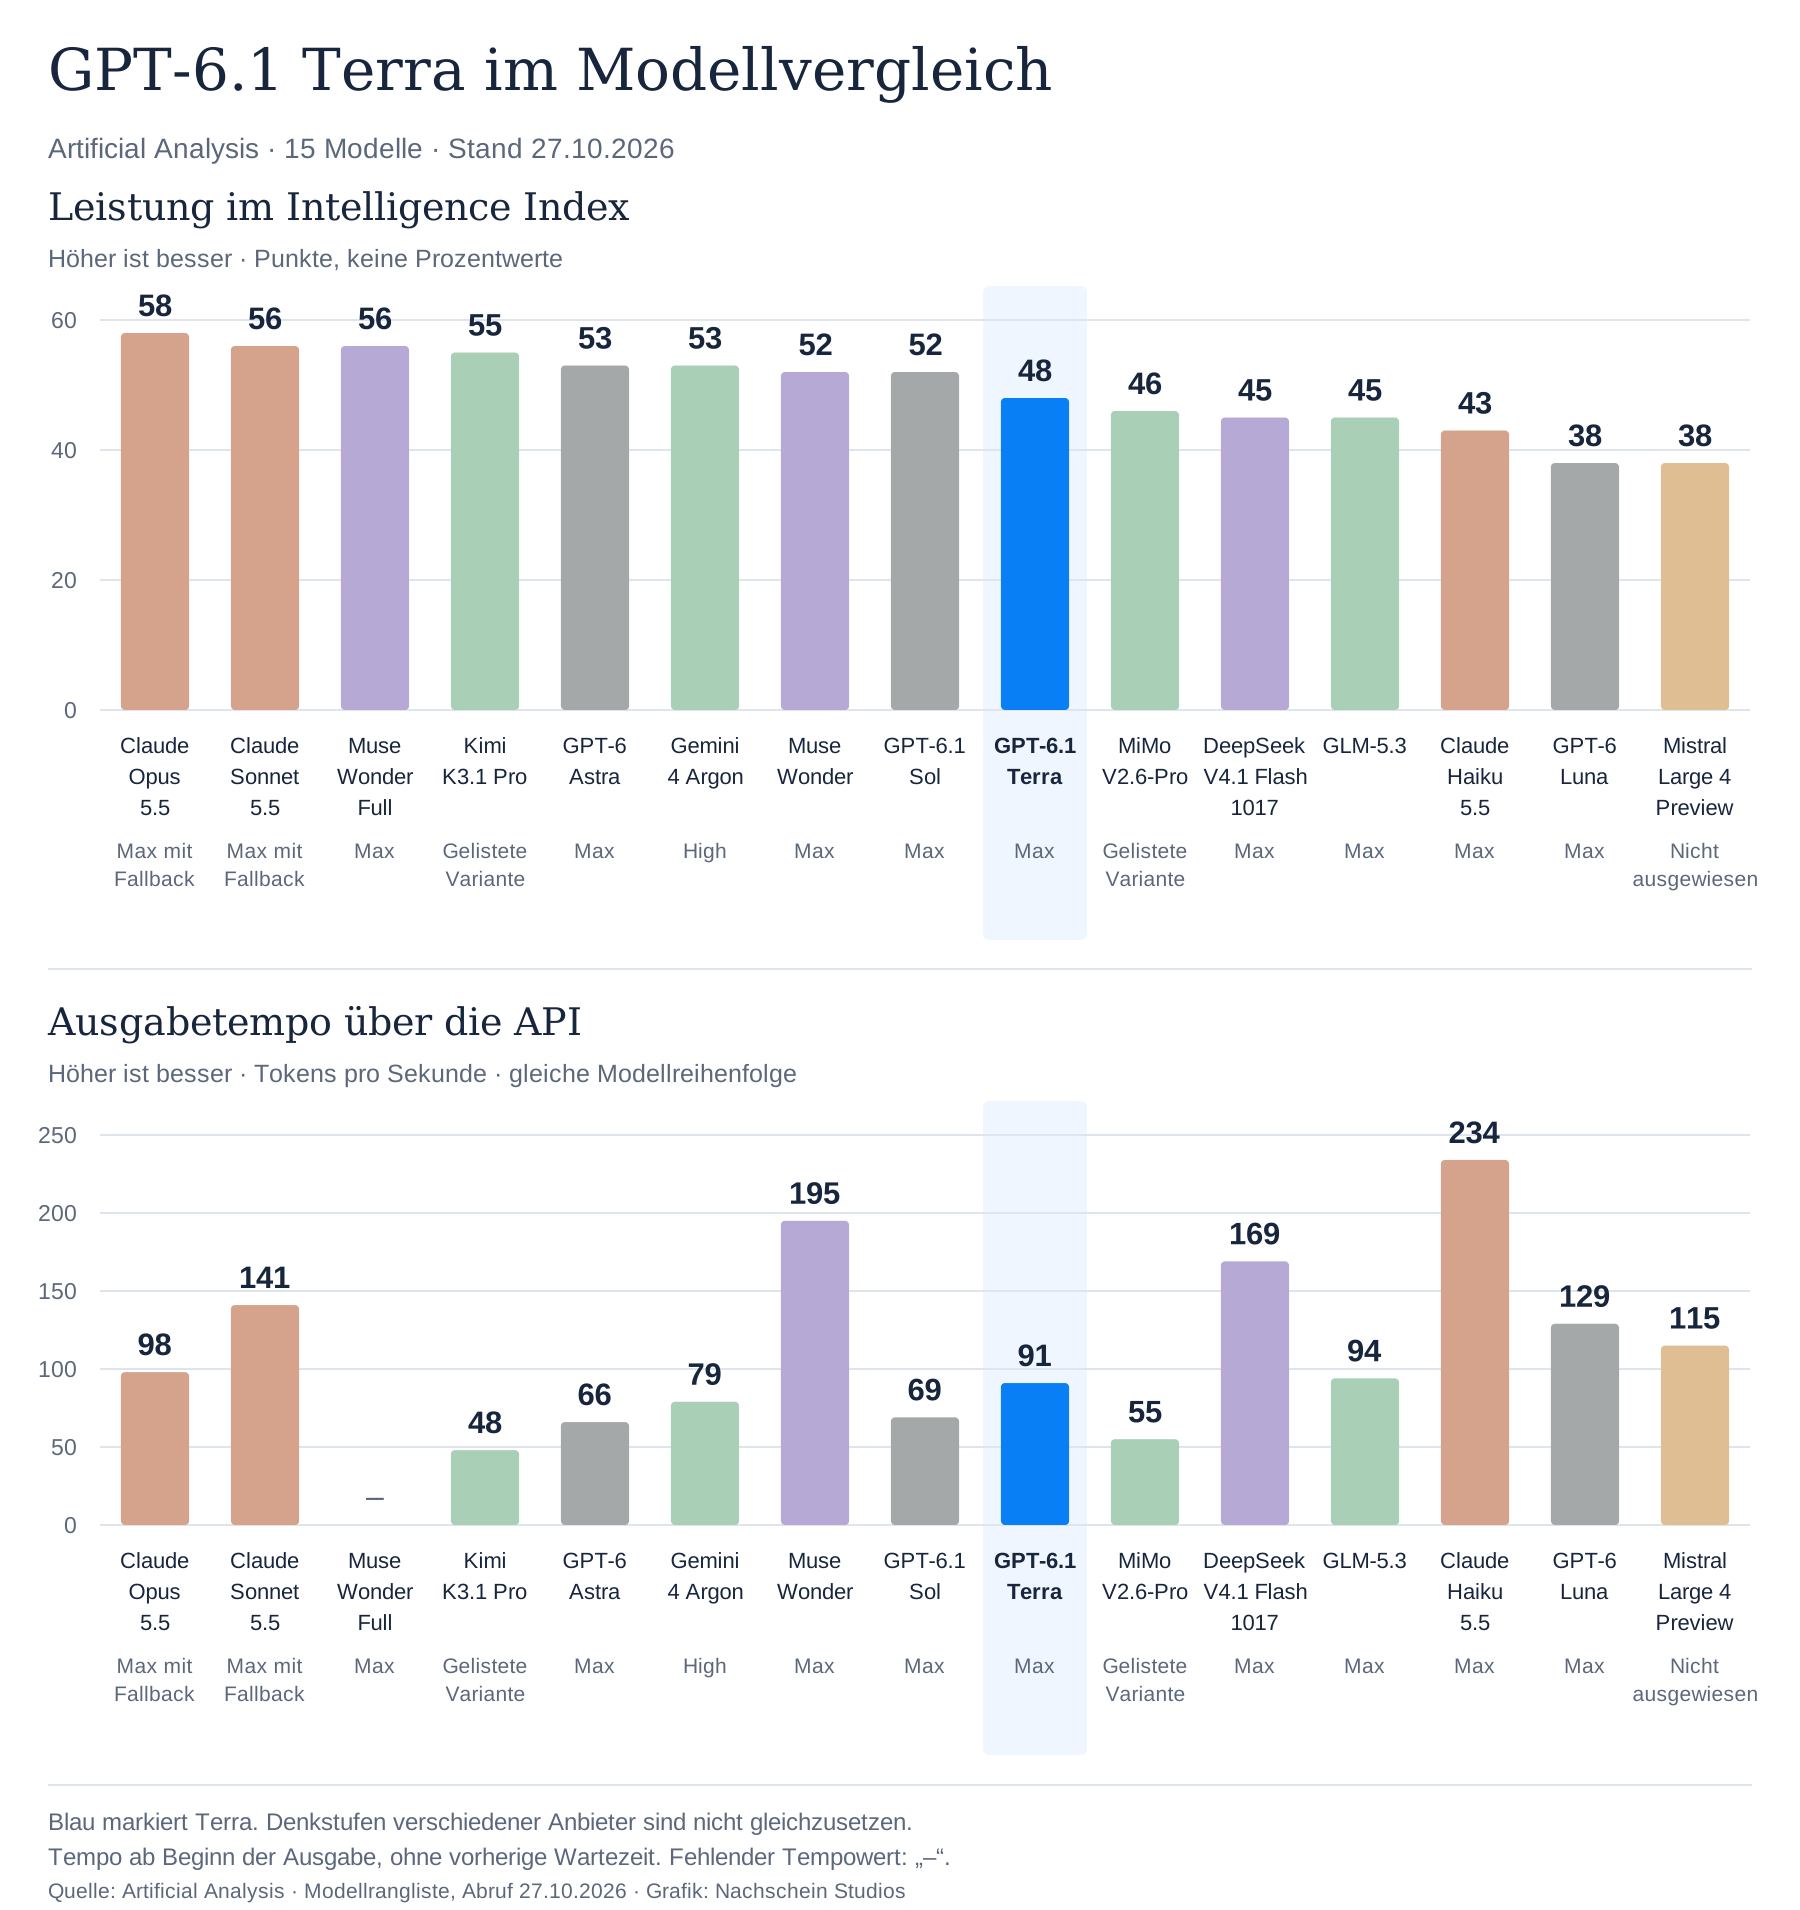
Artificial Analysis misst für GPT-6.1 Terra auf maximaler Denkstufe 48 Punkte im Intelligence Index v4.3.2. Der Vorgänger erreicht 42, GPT-6.1 Sol 52 Punkte. Zugleich sinken die gewichteten Kosten je Indexaufgabe von 1,40 auf 0,40 US-Dollar. Das sind Kosten innerhalb dieser Testreihe, kein Pauschalpreis für eine beliebige Aufgabe. Unabhängige Launch-Auswertung
Für die Einordnung zeigt die Grafik 15 ausgewählte Modelle aus der aktuellen Modellrangliste von Artificial Analysis. Claude Opus 5.5 erreicht 58 Punkte, Claude Sonnet 5.5 und Muse Wonder Full jeweils 56. Gemini 4 Argon und GPT-6 Astra liegen bei 53, Muse Wonder und GPT-6.1 Sol bei 52. Terra erreicht 48, DeepSeek V4.1 Flash in der Version 1017 kommt auf 45 Punkte. Die beschrifteten Denkstufen gehören zum jeweiligen Ergebnis; sie sind zwischen Anbietern nicht gleichzusetzen. Bei Opus und Sonnet ist „Max, Default Fallback“ gemeint.
Ein Index bündelt unterschiedliche Aufgaben. Sechs Punkte Zugewinn bedeuten daher nicht, dass Terra bei jeder einzelnen Tätigkeit im gleichen Maß besser wird. Für die Einordnung zählt auch, mit welcher Denkstufe das Ergebnis erreicht wurde. Die API bietet mehrere Stufen; die Voreinstellung ist „medium“. Denkstufen laut OpenAI
Die aktuelle Rangliste weist für Terras Texttempo inzwischen 91 Tokens pro Sekunde aus. Zum Vergleich: GPT-6.1 Sol liegt in der gezeigten Max-Variante bei 69, DeepSeek V4.1 Flash 1017 bei 169 und Claude Haiku 5.5 bei 234. Tokens sind kleine Textstücke, etwa Wortteile. Gemessen wird die Ausgabe nach deren Beginn; die vorherige Wartezeit kommt hinzu. Aus dem Ausgabetempo allein lässt sich deshalb nicht ablesen, wann eine vollständige Antwort fertig ist. Für Muse Wonder Full ist in der Rangliste kein Tempowert angegeben. Modellrangliste und Tempowerte
Zwei Tests zu Fehlern und erfundenen Antworten
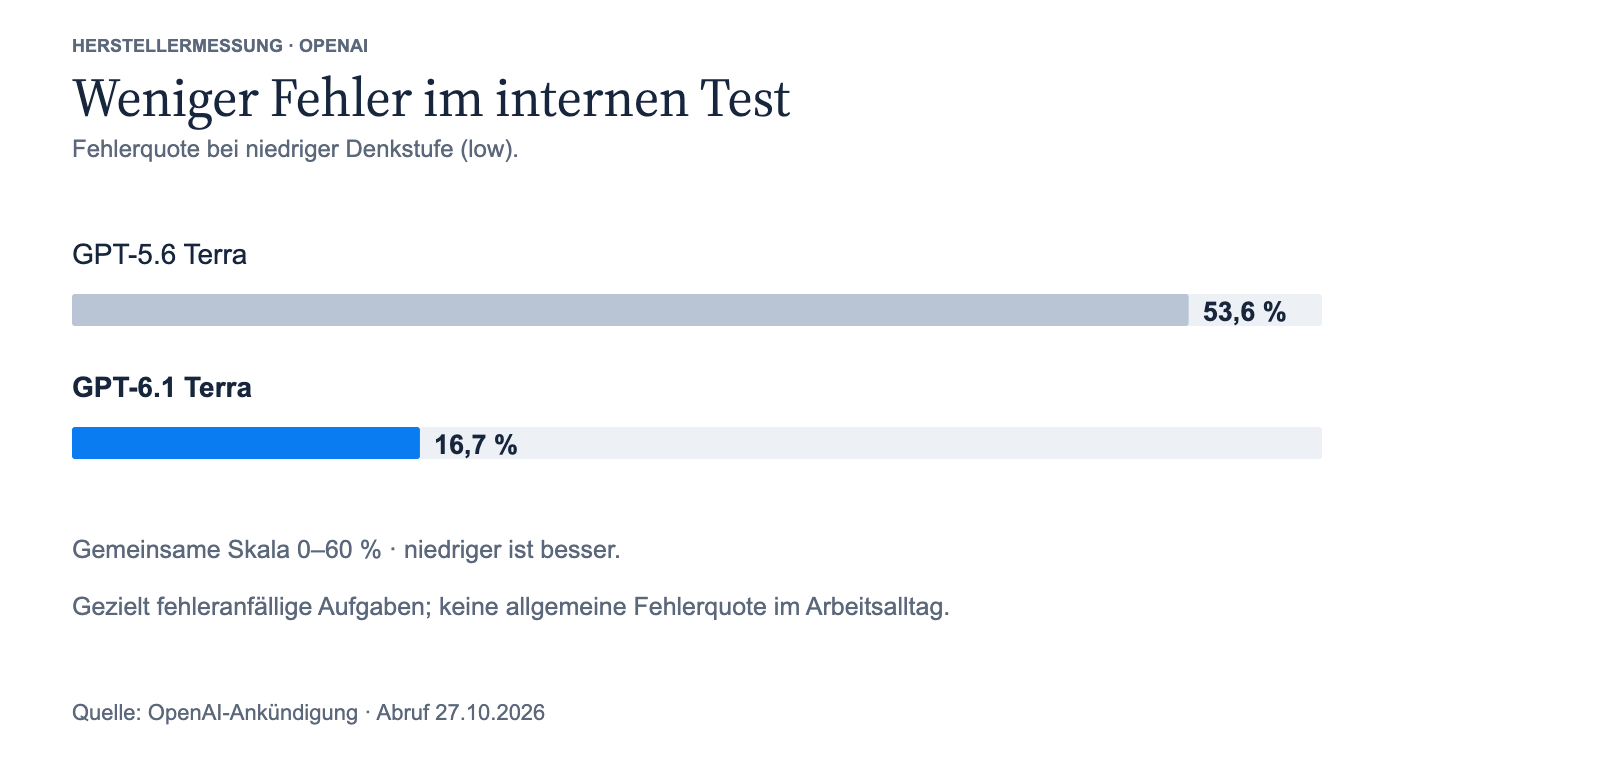
OpenAI meldet im internen Test mit gezielt fehleranfälligen Aufgaben bei niedriger Denkstufe einen Rückgang der Fehlerquote von 53,6 auf 16,7 Prozent. Das ist eine Herstellerangabe für diese Testsituation, keine gemessene Alltagsfehlerquote. OpenAIs Fehlertest
Artificial Analysis untersucht mit AA-Omniscience eine andere Frage: Wie oft rät das Modell, wenn es eine Antwort nicht weiß? Diese Rate sinkt laut Auswertung von 88 auf 38 Prozent. Gleichzeitig steigt die Antwortgenauigkeit um zwei Punkte. Die 38 Prozent dürfen deshalb weder als allgemeine Fehlerquote gelesen noch mit OpenAIs 16,7 Prozent verrechnet werden. Die Tests messen Verschiedenes. AA-Omniscience-Ergebnisse
Beide Befunde sprechen für Fortschritte bei der Verlässlichkeit. Eine geprüfte Quelle ersetzen sie nicht. Gerade bei Namen, Zitaten und fachlichen Aussagen bleibt entscheidend, ob eine konkrete Antwort nachvollziehbar belegt ist.
Die API wird mindestens halb so teuer
Die Standardpreise betragen je eine Million Text-Tokens 1 US-Dollar für Eingaben und 5 US-Dollar für Ausgaben. Bereits zwischengespeicherte Eingaben kosten 0,05 US-Dollar. Die Vorgängerdokumentation nennt 2, 12 und 0,20 US-Dollar. Daraus ergeben sich 50 Prozent weniger für Eingaben, rund 58 Prozent weniger für Ausgaben und 75 Prozent weniger für Cache-Eingaben. „Halb so teuer“ ist also eine vereinfachte Beschreibung unterschiedlicher Preissenkungen. Aktueller API-Preis · Preise des Vorgängers
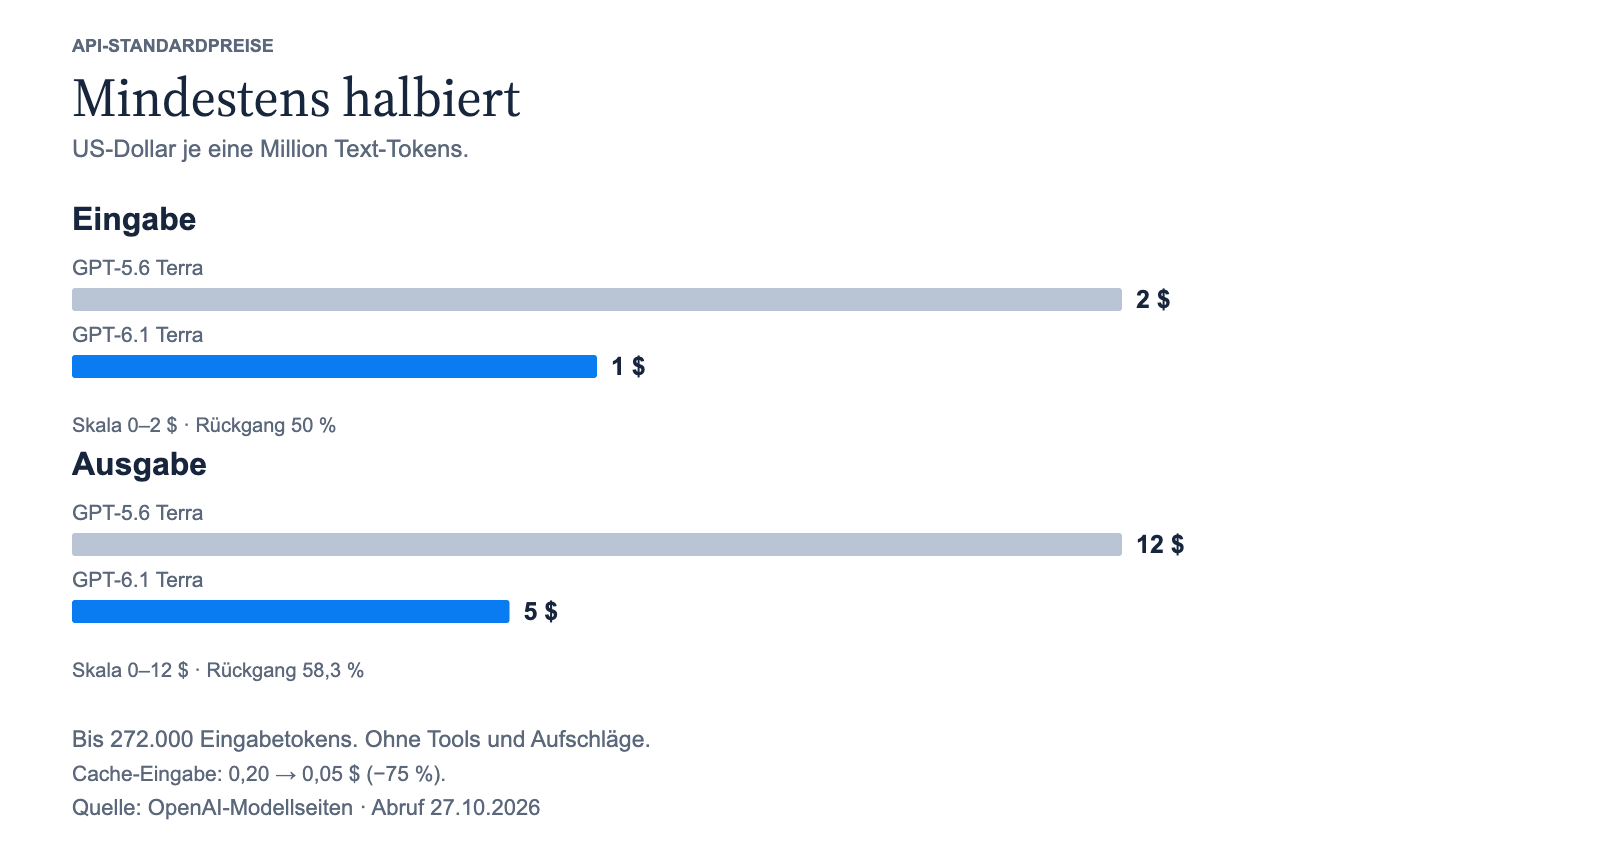
Die Rechnung hängt weiterhin vom tatsächlichen Verbrauch ab. Ein reines Rechenbeispiel: 100.000 Eingabetokens und 10.000 Ausgabetokens kosten zu diesen Standardpreisen 0,15 US-Dollar. Beim Vorgänger wären es 0,32 US-Dollar. Das Beispiel setzt ungecachte Texteingaben voraus und lässt zusätzliche Denk-Tokens, Werkzeuge und Aufschläge außer Betracht. Es ist keine Prognose für die Kosten eines echten Projekts.
Bei mehr als 272.000 Eingabetokens steigen die Preise für den gesamten Aufruf: Eingabe- und Cachepreise verdoppeln sich, der Ausgabepreis steigt auf das 1,5-Fache. Fast mode kostet ebenfalls mehr; Batch und Flex sind günstiger als Standard. Die niedrige Grundrate gilt daher nicht unverändert für jede Betriebsart. Preisbedingungen in der Modellkarte
Zugang über Work, Codex und die API
OpenAI nennt zum Start Plus, Pro, Enterprise und Edu für ChatGPT Work und Codex. Über die API heißt das Modell gpt-6.1-terra. Diese Ankündigung belegt keinen allgemeinen Zugang in jeder ChatGPT-Ansicht oder jedem Tarif. Verfügbarkeit laut OpenAI
Auch unabhängige Medien berichten über den Start. Decrypt ordnet Terra als Modell der mittleren Leistungsklasse ein, stützt die Angaben zur Fehlerquote aber auf OpenAIs Messungen. THE DECODER verweist zusätzlich auf Artificial Analysis. Ein weiterer Bericht über einen Herstellerbenchmark ist noch kein zweiter unabhängiger Test. Bericht bei Decrypt · Bericht bei THE DECODER
Der belegte Fortschritt liegt in der Verbindung aus besseren Testergebnissen und niedrigeren Tokenpreisen. Ob Terra einen konkreten Arbeitsablauf besser erledigt, lässt sich daraus noch nicht ableiten. Das bleibt eine Frage der Aufgabe, der Werkzeuge und der Kontrolle des fertigen Ergebnisses.
Quellen und Messbedingungen
Alle Quellen zuletzt am 27.10.2026 geprüft. Nachrichtenberichte sind kein Ersatz für unabhängige Messungen. Artificial Analysis und OpenAI verwenden unterschiedliche Tests; Werte werden nicht zwischen diesen Messreihen vermischt.
Die erweiterte Modellgrafik zeigt 15 ausgewählte Modelle aus der am 27.10.2026 abgerufenen Rangliste, jeweils mit einer beschrifteten Testvariante. Die Auswahl ist keine vollständige Rangliste. Bei Opus und Sonnet ist „Max, Default Fallback“ ausgewiesen; bei Kimi und MiMo nennt die Tabelle keine zusätzliche Denkstufe, bei Mistral keine eigene Denkstufe. Diese Konfigurationen entsprechen nicht automatisch einem normalen Chat und sind anbieterübergreifend nicht gleichzusetzen. Das Tempo ist der in der Rangliste angegebene Median der Ausgabetokens pro Sekunde, hier auf ganze Tokens dargestellt. Für Muse Wonder Full fehlt dieser Wert. Die beiden Diagramme verwenden dieselbe Modellreihenfolge und getrennte Skalen ab null. Preisgrafiken haben ebenfalls getrennte Skalen. Alle Preise sind US-Dollar je Million Text-Tokens.
- OpenAI: Ankündigung, 26.10.2026
- OpenAI: Modellkarte GPT-6.1 Terra
- OpenAI: Modellkarte GPT-5.6 Terra
- OpenAI: API-Preise und Betriebsarten
- Artificial Analysis: Terra-Launchauswertung, 26.10.2026
- Artificial Analysis: aktuelle Modellrangliste, Quelle der erweiterten Leistung-und-Tempo-Grafik
- Artificial Analysis: Terra-Releaseübersicht und Messdefinitionen
- Artificial Analysis: Claude Opus 5.5, Max, Default Fallback
- Artificial Analysis: Claude Sonnet 5.5, Max, Default Fallback
- THE DECODER: Ausgangsmeldung, 26.10.2026
- Decrypt: unabhängiger Medienbericht, 26.10.2026
Recherche-Stand: 27. Oktober 2026. Dieser Artikel beruht auf den verlinkten Quellen. Nachschein hat keinen eigenen Praxistest mit GPT-6.1 Terra durchgeführt. Herstellerangaben sind ausdrücklich zugeordnet; noch fehlende Messwerte bleiben offen.
Wie entstehen unsere Artikel?
Wir recherchieren öffentlich zugängliche Herstellerinformationen, unabhängige Messungen und Fachberichte. Eigene Tests kennzeichnen wir ausdrücklich. Nachrichten und Einordnung bleiben voneinander unterscheidbar.