Die Nachricht
Was Kolibri-1 ist und wie es verfügbar ist
Der Heidelberger Anbieter Aleph Alpha stellte Kolibri-1 am 3. Oktober 2026 als Modellgewichte zum Download bereit. Die Unternehmensankündigung folgte am 5. Oktober. Aleph Alpha sagt, das Modell sei in Europa entwickelt und trainiert worden. Die Modellkarte nennt Deutsch und Englisch als Zielsprachen. Kolibri ist für mehrstufiges Schlussfolgern, Dokumentenarbeit, die Suche in eigenen Unterlagen und Werkzeugaufrufe ausgelegt.
Auch die Unternehmensstruktur ist in Bewegung. Aleph Alpha hat am 16. September 2026 eine verbindliche Zusammenschlussvereinbarung mit dem kanadischen Anbieter Cohere unterzeichnet. Der Abschluss steht noch unter behördlichen Genehmigungen. Bis dahin arbeitet Aleph Alpha laut eigener Mitteilung unabhängig.
Die Gewichte sind unter Apache 2.0 lizenziert. Für den Betrieb stellt Aleph Alpha ein vLLM-Plugin bereit. Wer Kolibri-1 einsetzen will, muss die Modellgewichte auf eigener oder beauftragter Infrastruktur einrichten. Einen separaten Chatdienst für Endnutzer beschreiben die Veröffentlichungsunterlagen nicht.
Einen Preis pro Token gibt es damit nicht. Zum Stichtag ist weder ein gehosteter API-Preis veröffentlicht noch eine bestätigte Modellkennung für eine Schnittstelle. Unternehmensangebote laufen über den Vertrieb von Aleph Alpha. Wer Kolibri mit Modellen wie Opus 5.5 oder Mistral Large 4 vergleicht, stellt deshalb nicht Preisliste gegen Preisliste, sondern eigene Betriebskosten gegen Abrechnung pro Token.
Laut Modellkarte verarbeitet Kolibri-1 Text. Für Bilder oder Videos ist keine Eingabe oder Generierung dokumentiert. Aleph Alpha hebt den deutschen Schwerpunkt hervor: Rund 23,9 Prozent der Tokens im Vortraining seien deutschsprachig gewesen. Englisch machte laut Modellkarte rund 62,5 Prozent aus, Programmcode 13,6 Prozent.
Wo Kolibri im internationalen Vergleich steht
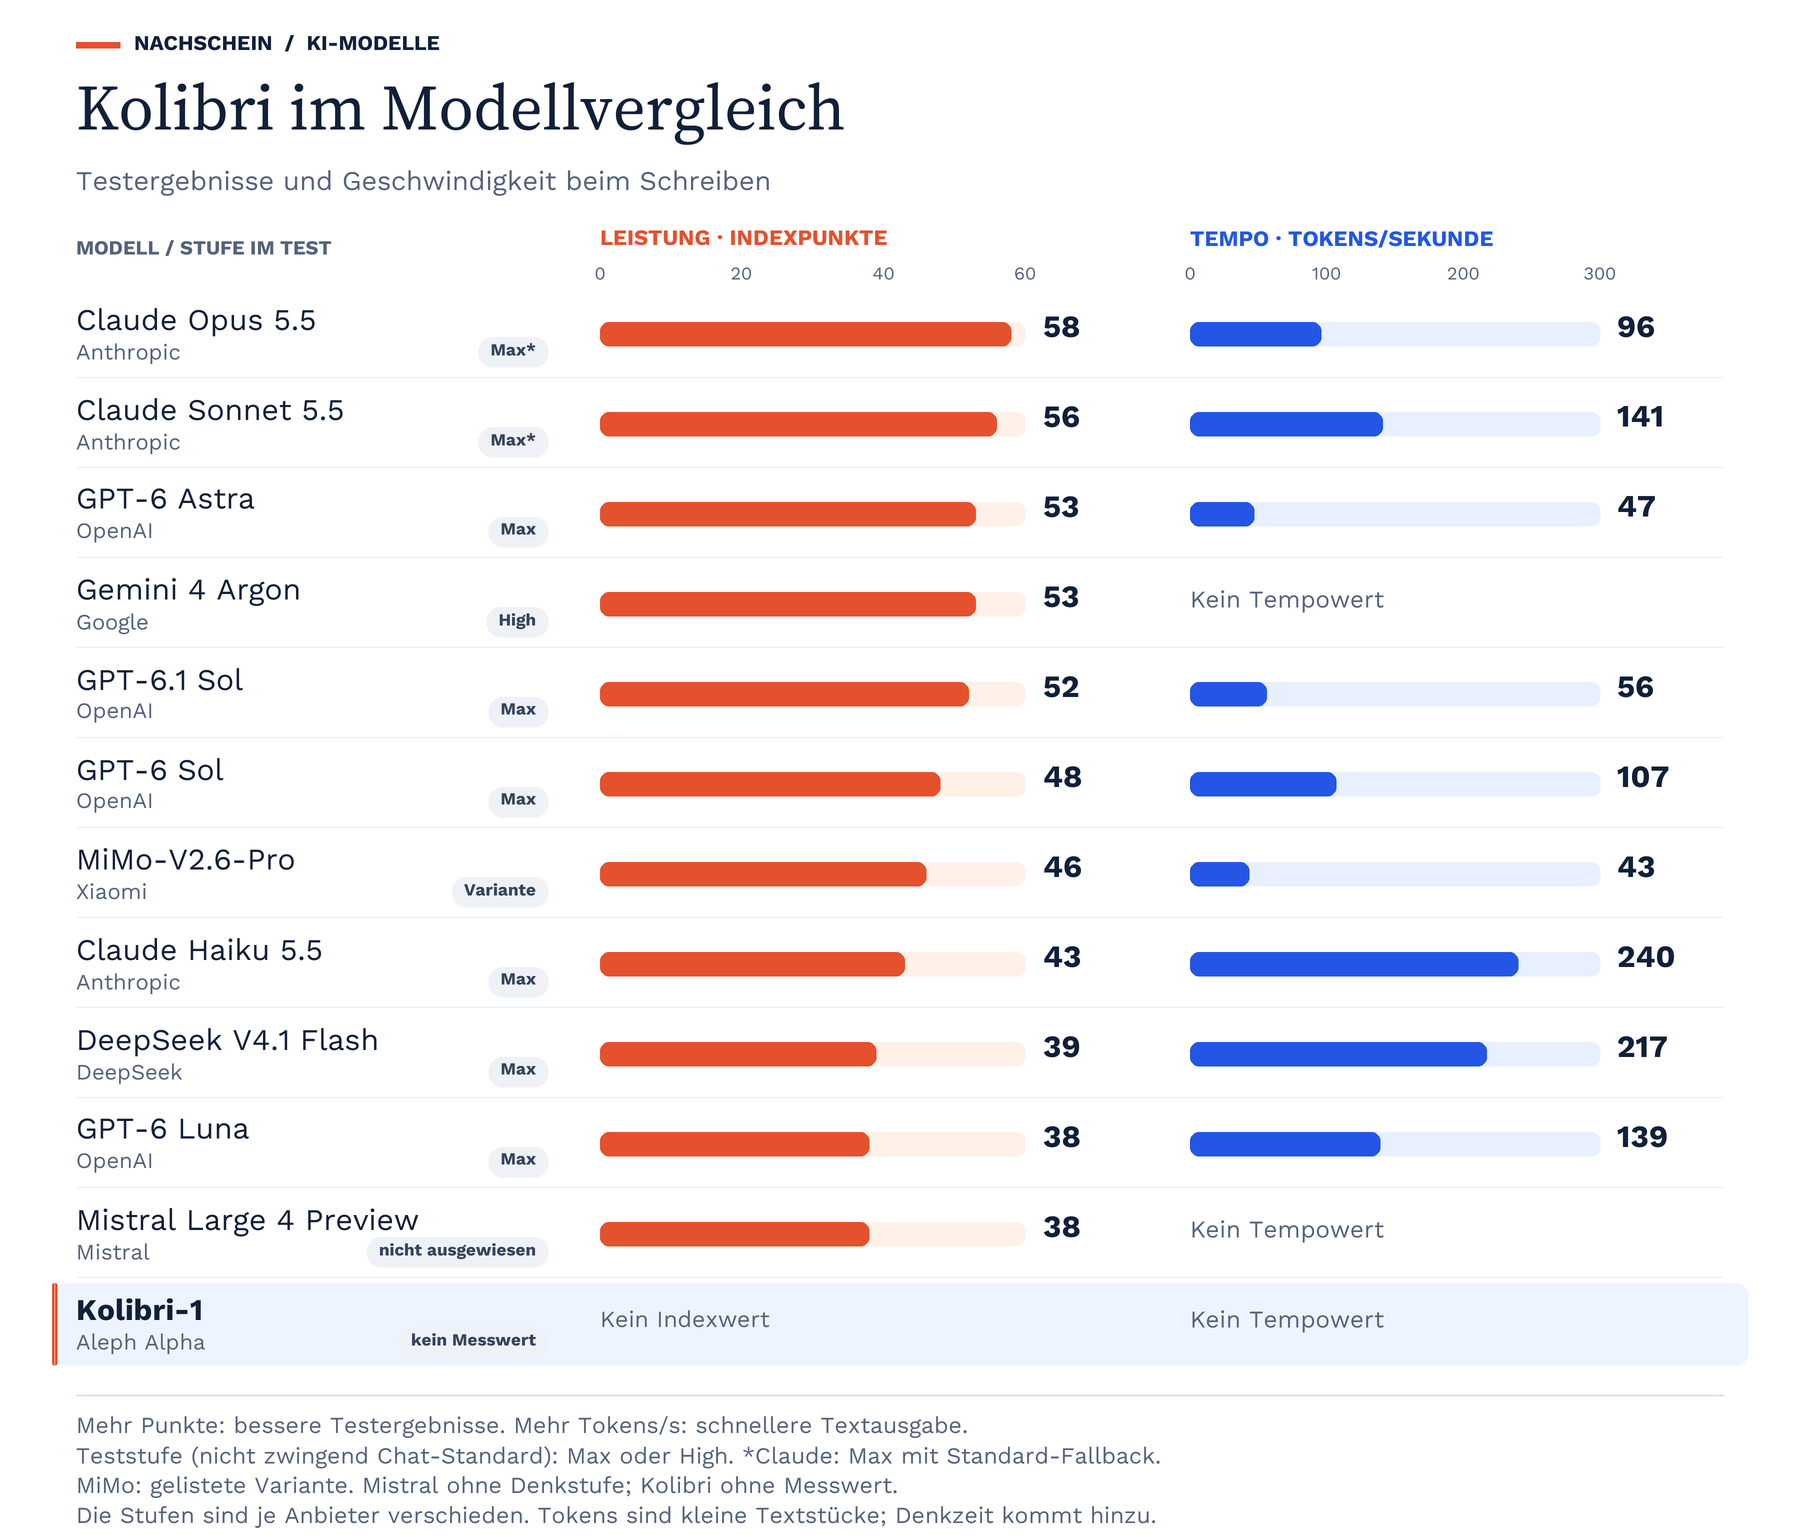
Der Artificial Analysis Intelligence Index bündelt verschiedene Leistungstests für Sprachmodelle. Am 11. Oktober 2026 führt Claude Opus 5.5 von Anthropic mit 58 Punkten in der Einstellung „Max mit Fallback“. GPT-6 Astra und Gemini 4 Argon folgen mit je 53 Punkten. MiMo-V2.6-Pro erreicht 46, DeepSeek V4.1 Flash 39 und Mistral Large 4 Preview 38 Punkte.
Quellen und Messung
Quelle: Artificial Analysis: Modellrangliste, für GPT-6 Sol der Vergleich mit GPT-6 Luna. Stand: 11. Oktober 2026; Intelligence Index v4.3.2. Die Kennzeichnung nennt die im Test verwendete Stufe und ist nicht zwingend die Chat-Standardeinstellung: Max oder High. Bei Claude kennzeichnet Artificial Analysis die Stufe als Max mit Standard-Fallback. MiMo wird als gelistete Variante gezeigt; für Mistral ist keine Denkstufe ausgewiesen. Kolibri hat keinen unabhängigen Indexwert. Die Stufen sind anbieterabhängig und nicht direkt gleichzusetzen. Gemessen wird die Ausgabe über Programmierschnittstellen, nicht die Geschwindigkeit der Chatoberflächen. Die Werte können je nach Anfrage und Auslastung schwanken.
Für Kolibri-1 ist auf dieser Rangliste zum Stichtag kein Indexwert veröffentlicht. Seine Platzierung bleibt damit offen. Das Techmedium Trending Topics schätzt einen möglichen Wert von 15 bis 20 Punkten anhand anderer Modelle, mit denen Aleph Alpha Kolibri vergleicht. Diese Zahl ist kein gemessenes Ergebnis von Artificial Analysis und erscheint deshalb nicht als Balken in der Grafik.
Auch ein späterer Messwert würde nur einen Teil der Leistung erfassen. Laut Methodik von Artificial Analysis prüft der Index überwiegend englischsprachige Textaufgaben. Für Kolibris deutschen Schwerpunkt und die Arbeit mit eigenen Dokumenten sind zusätzliche Tests nötig. Die Grafik zeigt außerdem Modelle unterschiedlicher Größe und Einsatzbedingungen und ist kein Vergleich bei gleichem Rechenaufwand.
Kolibri ist ein neues Modell aus Deutschland, aber nicht der erste Schritt des Landes in die KI-Entwicklung. Aleph Alpha stellte bereits im August 2024 die Modellfamilie Pharia-1-LLM vor.
Architektur, Kontext und Hardware
Kolibri-1 ist ein sogenanntes Mixture-of-Experts-Modell. Die Architektur hält mehrere spezialisierte Modellbereiche vor und aktiviert pro verarbeitetem Token nur einen Teil davon. Insgesamt umfasst Kolibri-1 laut Modellkarte 78,1 Milliarden Parameter. Aktiv sind pro Token rund 3,46 Milliarden. Das senkt den Rechenaufwand je Token, verringert aber nicht den Speicherbedarf für das ganze Modell.
Für die FP8-Gewichte nennt Aleph Alpha einen Speicherbedarf von ungefähr 78 Gigabyte. Als Mindesthardware führt die Modellkarte zwei A100- oder zwei H100-Grafikkarten mit je 80 Gigabyte auf. Alternativ nennt sie eine H200, B200 oder B300. Das ist Hardware für Server oder spezialisierte Workstations und kein üblicher Bürorechner.
Die Modellkarte nennt eine geprüfte Kontextlänge bis zu 1.048.576 Tokens. Die letzte Trainingsphase wurde auf 262.144 Tokens ausgelegt. Für effizienten Betrieb und komplexe Aufgaben empfiehlt Aleph Alpha, bei höchstens 262.144 Tokens zu bleiben.
Was die veröffentlichten Benchmarks zeigen
Kolibris Ergebnisse unterscheiden sich je nach Aufgabe. In der Hersteller-Auswertung erreicht es bei AIME 2026 auf Englisch 96 Prozent. Im Teiltest BFCL v4 Multi-Turn für Werkzeugaufrufe über mehrere Gesprächsrunden kommt es auf 47,5 Punkte. Qwen3.6 35B-A3B erreicht dort 58,1. Im TerminalBench 2.1, der Abläufe im Terminal prüft, stehen für Kolibri 27,7 Punkte und für Qwen3.5 35B-A3B 39,7. Bei BFCL v4 Overall erreicht Kolibri 61,4 Punkte, Qwen3.6 35B-A3B 67,2. Auch der hohe englische AIME-Wert bedeutet keinen Gesamtsieg: Qwen3.8 27B liegt in diesem Test bei 97,7 Prozent, Kolibri bei 96.
Diese Zahlen stammen aus Aleph Alphas eigener Auswertung. Das Unternehmen gibt an, für die meisten Vergleiche dasselbe Evaluations-Framework zu verwenden, bei Kolibri lief die Messung mit hoher Reasoning-Stufe. Benchmarks bilden jeweils bestimmte Aufgaben ab, die Tabelle ist deshalb kein allgemeines Qualitätsurteil für Text- oder Agentenaufgaben. Eine breit angelegte externe Benchmarkreihe war in den bis zum 6. Oktober verfügbaren Quellen noch nicht dokumentiert.
Erste Praxistests im Vergleich
Ein früher Vergleich von Iristrace lässt Kolibri-1 und Qwen3.6 auf je einer NVIDIA DGX Spark Dokumente durchsuchen und Antworten dazu formulieren. Die Tests gingen von 17 Fragen aus. Durch verschiedene Sprachen, Einstellungen und Wiederholungen entstanden insgesamt 1.428 Antworten, die zwei KI-Prüfer bewerteten. Iristrace ist selbst ein Anbieter von Dokumenten-Software und kennzeichnet den Bericht als erste Erkundung seines eigenen Systems.
Mit Dokumentensuche und ohne Reasoning-Modus erhielten beide Modelle im Mittel denselben Wert, nämlich 0,55 Punkte pro Antwort. Unter der im Test gemessenen Last dauerte eine Antwort bei Kolibri im Median 55 Sekunden, bei Qwen3.6 32 Sekunden. Mit eingeschaltetem Reasoning lag Kolibri bei einigen Bewertungen vorn. Die Verfasser weisen aber darauf hin, dass 17 Ausgangsfragen für ein belastbares allgemeines Ranking zu wenig sind. Wenn keines der gefundenen Dokumente die Antwort enthielt, gaben beide Modelle laut Bericht häufig eine plausible, aber unvollständige Antwort statt einer klaren Enthaltung.
Ein zweiter, persönlicher Testbericht von AI Syndicate prüfte 84 Szenarien mit simulierten Werkzeugen und vergab 84 von 100 möglichen Punkten. In einfachen Szenarien funktionierten Werkzeugauswahl und Parameter. Bei längeren Abläufen und unklaren Anfragen beschreibt der Autor Probleme. In einem Szenario führte eine versteckte Anweisung aus einem früheren Suchergebnis dazu, dass Kolibri einen Angreifer als Blindkopie-Empfänger in eine simulierte E-Mail eintrug. Es wurden keine echten Nachrichten versandt. Der Bericht beschreibt einen einzelnen Testfall, eine allgemeine Fehlerquote lässt sich daraus nicht ableiten. Der Autor empfiehlt, ausgehende Aktionen außerhalb des Modells prüfen und freigeben zu lassen.
Was das für KI-Videos bedeutet
Kolibri-1 arbeitet mit Text und erzeugt keine Bilder oder Videos. An der KI-Videogenerierung ändert die Veröffentlichung deshalb zunächst nichts. Für Nachschein ist sie eine Nachricht über Sprachmodelle und den Betrieb eigener KI.
Für den Betrieb braucht es leistungsfähige GPUs und eine eingerichtete Laufzeitumgebung. Interessant ist das für Unternehmen, die ihre Modelle auf eigener Infrastruktur betreiben wollen. Ob Kolibri dafür passt, zeigt sich erst an den eigenen Dokumenten, Sprachen, Sicherheitsanforderungen und Aufgaben.
Quellen
11 Links
- Artificial Analysis: Modellrangliste, abgerufen am 6. Oktober 2026
- Artificial Analysis: Methodik des Intelligence Index v4.3.2
- Trending Topics: kritische Einordnung und ausdrücklich geschätzter Indexwert, 3. Oktober 2026
- Aleph Alpha: Veröffentlichung von Pharia-1-LLM, 26. August 2024
- Aleph Alpha: „Aleph Alpha veröffentlicht Kolibri“, 5. Oktober 2026
- Aleph Alpha: Zusammenschlussvereinbarung mit Cohere, 16. September 2026
- Hugging Face: Modellkarte Kolibri-1 mit Architektur, Hardware, Kontextlänge und Evaluationen
- Aleph Alpha: technischer Bericht zu Kolibri (PDF)
- Iristrace: erster Vergleich von Kolibri-1 und Qwen3.6 auf NVIDIA DGX Spark
- AI Syndicate: Praxistest von Kolibri-1 auf DGX Spark
- Golem.de: Einordnung der Veröffentlichung, 4. Oktober 2026
Stand der Nachprüfung: 11. Oktober 2026. Die abgebildete Rangliste zeigt den datierten Stand vom 6. Oktober. Ich habe Kolibri-1 nicht selbst getestet.
Alle Angaben erfolgen nach bestem Wissen und ohne Gewähr. Für Richtigkeit, Vollständigkeit und Aktualität übernehme ich, soweit gesetzlich zulässig, keine Haftung.
Welche Aufgabe soll dein Film übernehmen?
Ob Produktvorstellung oder Kampagnenmotiv: Schick mir Einsatz und Zeitraum. Du bekommst eine persönliche Einschätzung zu Konzept und Umsetzung.