
Die Nachricht
Meta hat am 12. Oktober 2026 zwei neue Sprachmodelle vorgestellt, Muse Wonder und Muse Wonder Full. Der Konzern nennt sie seine bisher leistungsfähigsten Modelle. Bei Artificial Analysis, einem unabhängigen Vergleichsportal, landet Wonder Full zwei Punkte hinter Claude Opus 5.5 und gleichauf mit Claude Sonnet 5.5. Wonder Full gibt es nur im Muse-Code-Abo. Muse Wonder ist über Schnittstellen erreichbar, auch über Zwischenhändler. Die Muse-App, in die Muse Wonder erst noch kommen soll, gibt es in Deutschland bisher nicht.
Zwei Modelle, zwei Zugänge
Muse Wonder ist für Entwickler gedacht und läuft über Metas Model API sowie im Coding-Werkzeug Muse Code. Wonder Full, laut Model Card die leistungsstärkere Variante, bekommen nur Abonnenten von Muse Code. Eine öffentliche Schnittstelle gibt es dafür nicht. In die Muse-App soll Muse Wonder „bald“ kommen, zuerst für Abonnenten. Wonder Full nennt Meta dafür nicht, zu kostenlosen Nutzern sagt Meta nichts.
Laut Model Card verarbeiten beide Modelle Text, Bilder, Video und Audio. Antworten kommen aber nur als Text. Dazu zählt auch Code, aus dem sich etwa Grafiken oder Animationen im Browser erzeugen lassen. Das Kontextfenster fasst eine Million Tokens. Laut TechCrunch hat Meta die Modelle im Rechenzentrum Prometheus in Ohio trainiert. Die Trainingsdaten umfassen viele Sprachen, geprüft hat Meta das Modell aber nicht in allen. Deutsch wird in der Model Card nicht erwähnt. Wie gut die Modelle Deutsch können, bleibt also offen.
Offene Gewichte nennt Meta für Wonder nicht, Artificial Analysis führt das Modell als proprietär. Schon Muse Spark kam im April ohne offene Gewichte. Ganz aufgegeben hat Meta offene Modelle aber nicht. Im August erschien Muse Glimmer, ein Modell mit offenen Gewichten, das auf normaler Hardware laufen soll.
Was Meta verspricht
Meta baut die Wonder-Modelle vor allem für Agenten, also für Aufgaben, die ein Modell über viele Schritte selbst abarbeitet. Als Beispiele nennt das Unternehmen, einen Versicherungsfall durchzugehen, einen Mietvertrag zu verstehen, die eigenen Finanzen zu durchschauen oder eine lauffähige App zu bauen. Stark sein sollen die Modelle bei Recht, Finanzen, Gesundheit und Programmierung.
Zwei Funktionen stellt Meta besonders heraus. Active Memory soll wichtigen Kontext von einem Gespräch ins nächste mitnehmen und wieder hervorholen, wenn eine Aufgabe ihn braucht. Active Focus soll das Modell bei schwierigen Aufgaben am Ziel halten. Kommt es nicht weiter, probiert es andere Wege oder fragt nach. Vor wichtigen Schritten soll es sich melden.
Die Vergleichstabelle von Meta
Meta stellt seine Modelle in einer Vergleichstabelle neben GPT-6 Astra, Claude Fable 5.1 und Claude Opus 5.5. Das sind Herstellerangaben, aber nicht alles hat Meta selbst gemessen. Laut Model Card stammen einzelne Werte von Dritten, etwa von Artificial Analysis, Vals AI oder Abundant AI, und bei Opus 5.5 teils aus Anthropics eigenen Angaben. Im Fließtext der Model Card habe ich die Zahlen nicht gefunden, ich gebe sie so wieder, wie Decrypt und der Entwickler Gabriel Anhaia sie übernommen haben. Wonder Full liegt dort in mehreren Tests vorn, etwa im Personal Superintelligence Index mit 59,1 zu 55,2 Punkten gegenüber Opus 5.5 und im Gedächtnistest MemoryBench mit 85,5 zu 81,5. Diese beiden Tests hat Meta selbst entwickelt. Im Programmiertest SWE-Marathon von Abundant AI steht es 57,5 zu 46,3. Meta räumt ein, dass diese Zeile kein kontrollierter Vergleich in gleicher Testumgebung ist, und nennt für Wonder Full die Rechenstufe xhigh.
Aufschlussreicher ist das kleinere Muse Wonder, denn nur dieses Modell gibt es über die Schnittstelle, zum selben Preis wie Opus 5.5. Anhaia hat die Vergleichstabelle für Muse Wonder in 14 Zeilen übernommen. Eine davon ist der Index von Artificial Analysis, weitere Werte stammen ebenfalls von Dritten. Muse Wonder gewinnt nur 5 dieser 14 Zeilen gegen Opus, eine davon mit 0,2 Punkten Abstand. Beim Programmiertest DeepSWE führt es mit 78,8 zu 74,2 Punkten. Bei ProgramBench, wo ein Programm von Grund auf entsteht, liegt Opus mit 70,5 zu 50,0 klar vorn.
Was unabhängig gemessen wurde
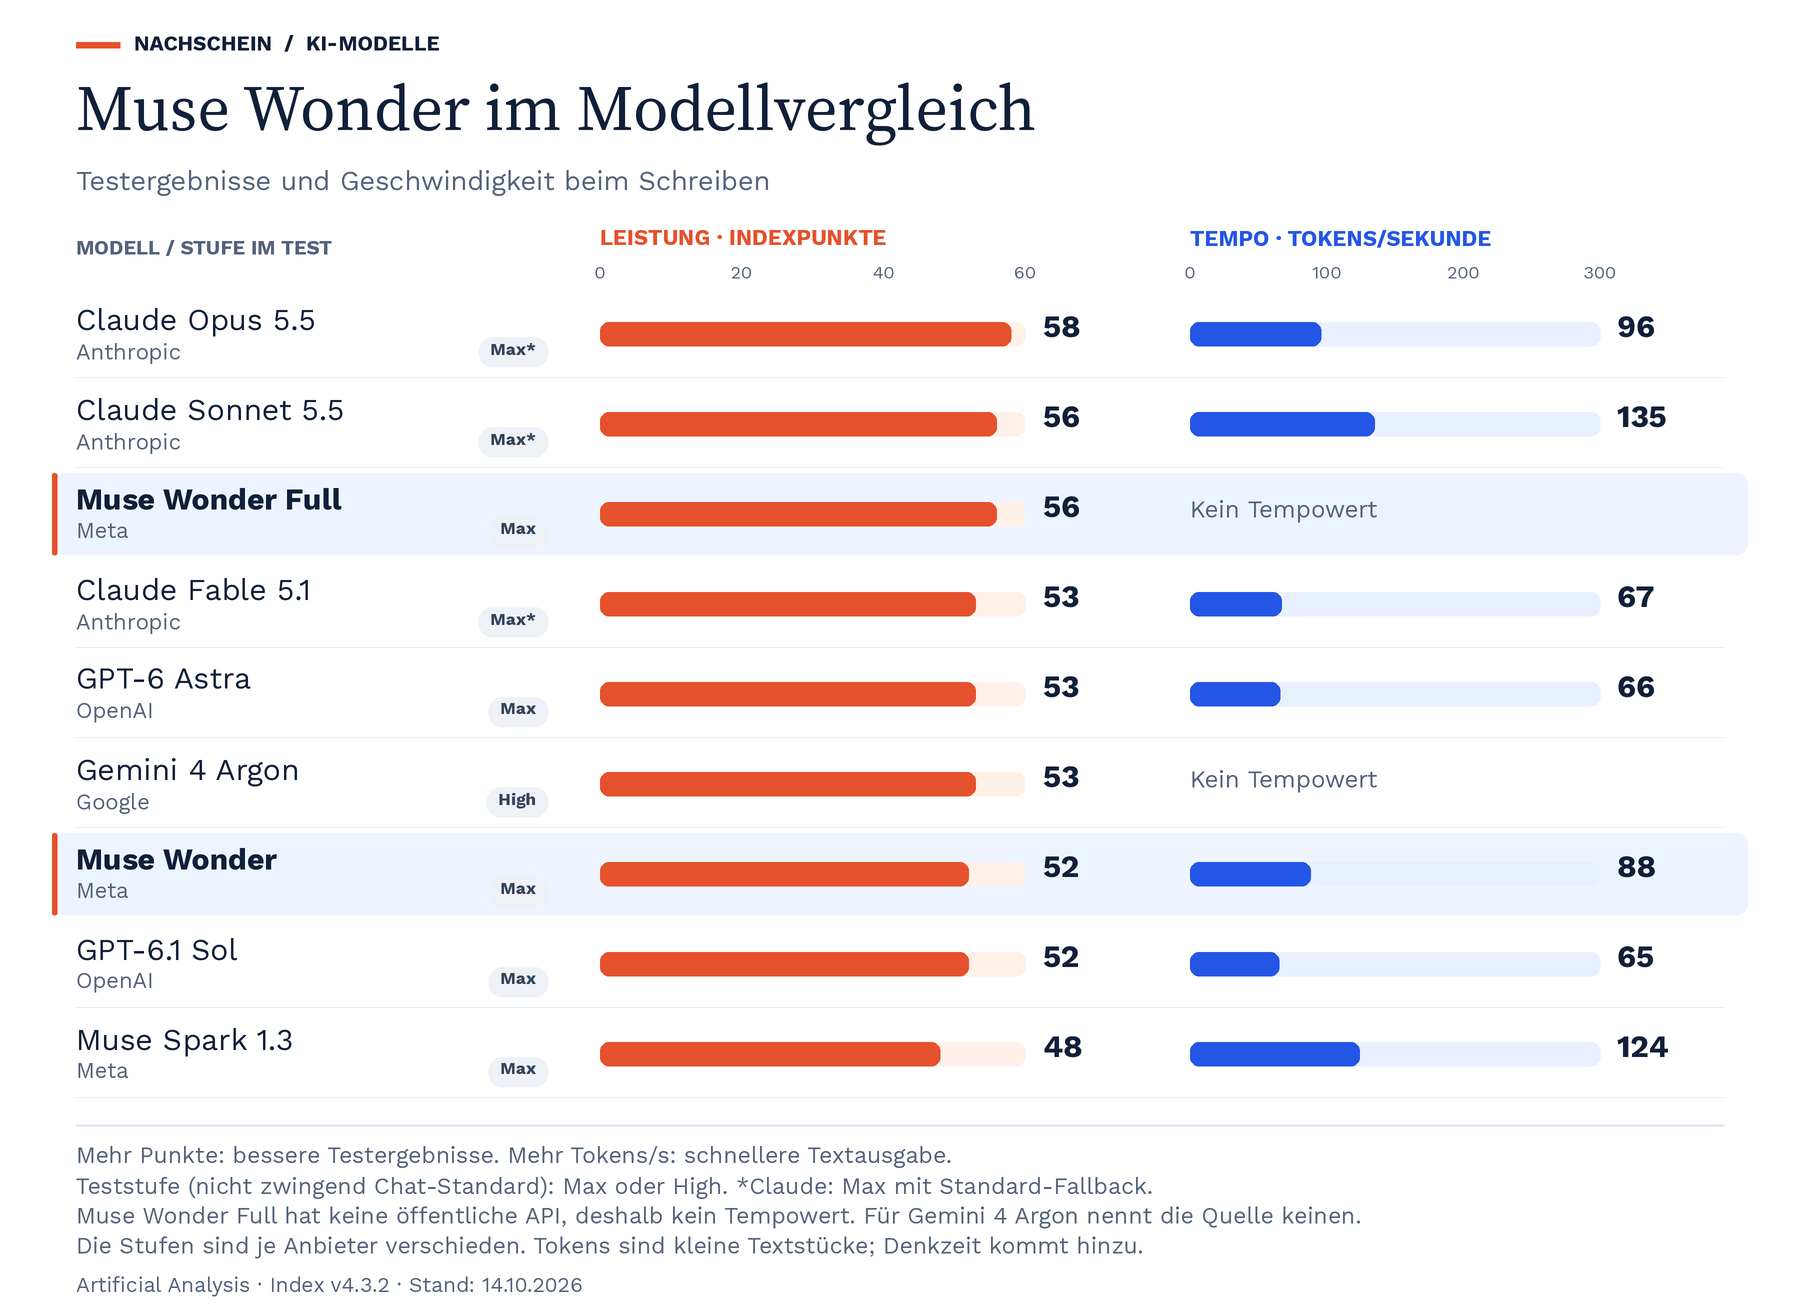
Artificial Analysis hat beide Modelle in seinen Intelligence Index aufgenommen. Wonder Full erreicht dort 56 Punkte, so viel wie Claude Sonnet 5.5. Vorn liegt Claude Opus 5.5 mit 58. Muse Wonder kommt auf 52, gleichauf mit GPT-6.1 Sol und einen Punkt hinter GPT-6 Astra, Claude Fable 5.1 und Gemini 4 Argon. Der Vorgänger Muse Spark 1.3 stand bei 48.
Quellen und Messung
Quelle: Artificial Analysis: Modellrangliste, ergänzt um den Artikel zu Muse Wonder. Stand: 14. Oktober 2026; Intelligence Index v4.3.2. Die Kennzeichnung nennt die im Test verwendete Stufe und ist nicht zwingend die Chat-Standardeinstellung. Bei Claude kennzeichnet Artificial Analysis die Stufe als Max mit Standard-Fallback, Gemini 4 Argon lief auf High. Die Stufen sind anbieterabhängig und nicht direkt gleichzusetzen. Gemessen wird über Programmierschnittstellen, nicht in den Chatoberflächen. Tempo und Kosten können je nach Anfrage und Auslastung schwanken. Für Muse Wonder nennt die Modellseite ein höheres Tempo von 115 Tokens pro Sekunde als die Rangliste. Die Grafik nutzt für alle Modelle die Rangliste.
Neben den Punkten zeigt die Grafik das Schreibtempo über die Schnittstelle. Muse Wonder gibt laut Rangliste 88 Tokens pro Sekunde aus, Opus 5.5 kommt auf 96, GPT-6 Astra auf 66. Für Wonder Full gibt es keinen Tempowert, weil es keine öffentliche Schnittstelle hat.
Beim Faktenwissen sieht Artificial Analysis eine relative Schwäche beider Modelle. Im Wissenstest AA-Omniscience erreicht Wonder Full 30 Punkte und Muse Wonder 25, Opus 5.5 kommt auf 46. Die Halluzinationsrate von Wonder Full ist laut Artificial Analysis gegenüber Muse Spark 1.3 von 33 auf 23 Prozent gesunken, Muse Wonder liegt bei 27 Prozent. Meta selbst nennt in der Model Card eine weitere Lücke. Visuelles und räumliches Denken, besonders bei 3D-Aufgaben, sei eine bekannte Schwäche.
Auch bis zur ersten Ausgabe dauert es. In der Rangliste misst Artificial Analysis bei Muse Wonder gut 19 Sekunden bis zum ersten Textstück, auf der Modellseite nennt es gut 36 Sekunden bis zum ersten Token. Woher der Unterschied kommt, erklärt Artificial Analysis nicht. Ähnlich teure Modelle liegen laut Modellseite im Median bei rund 6 Sekunden. So kurz nach dem Start können sich solche Werte noch deutlich verschieben.
Der Preis
Über die API kostet Muse Wonder 4 US-Dollar pro Million Input-Tokens und 20 Dollar pro Million Output-Tokens, gecachter Input kostet 0,20 Dollar. Das ist derselbe Listenpreis wie bei Claude Opus 5.5. Mehr sagt der Preis pro Aufgabe, weil darin steckt, wie viele Tokens ein Modell tatsächlich verbraucht. Artificial Analysis kommt bei Muse Wonder auf 4,52 Dollar je Aufgabe aus seinem Index, bei Opus 5.5 auf 5,98 und bei Sonnet 5.5 auf 5,46 Dollar. Deutlich günstiger sind GPT-6.1 Sol mit 0,72 und Gemini 4 Argon mit 1,99 Dollar. Artificial Analysis stuft den Input-Preis als „somewhat expensive“ ein, den Output-Preis als „expensive“. Wonder Full hat keinen Tokenpreis, deshalb gibt es auch keinen Kostenwert je Aufgabe.
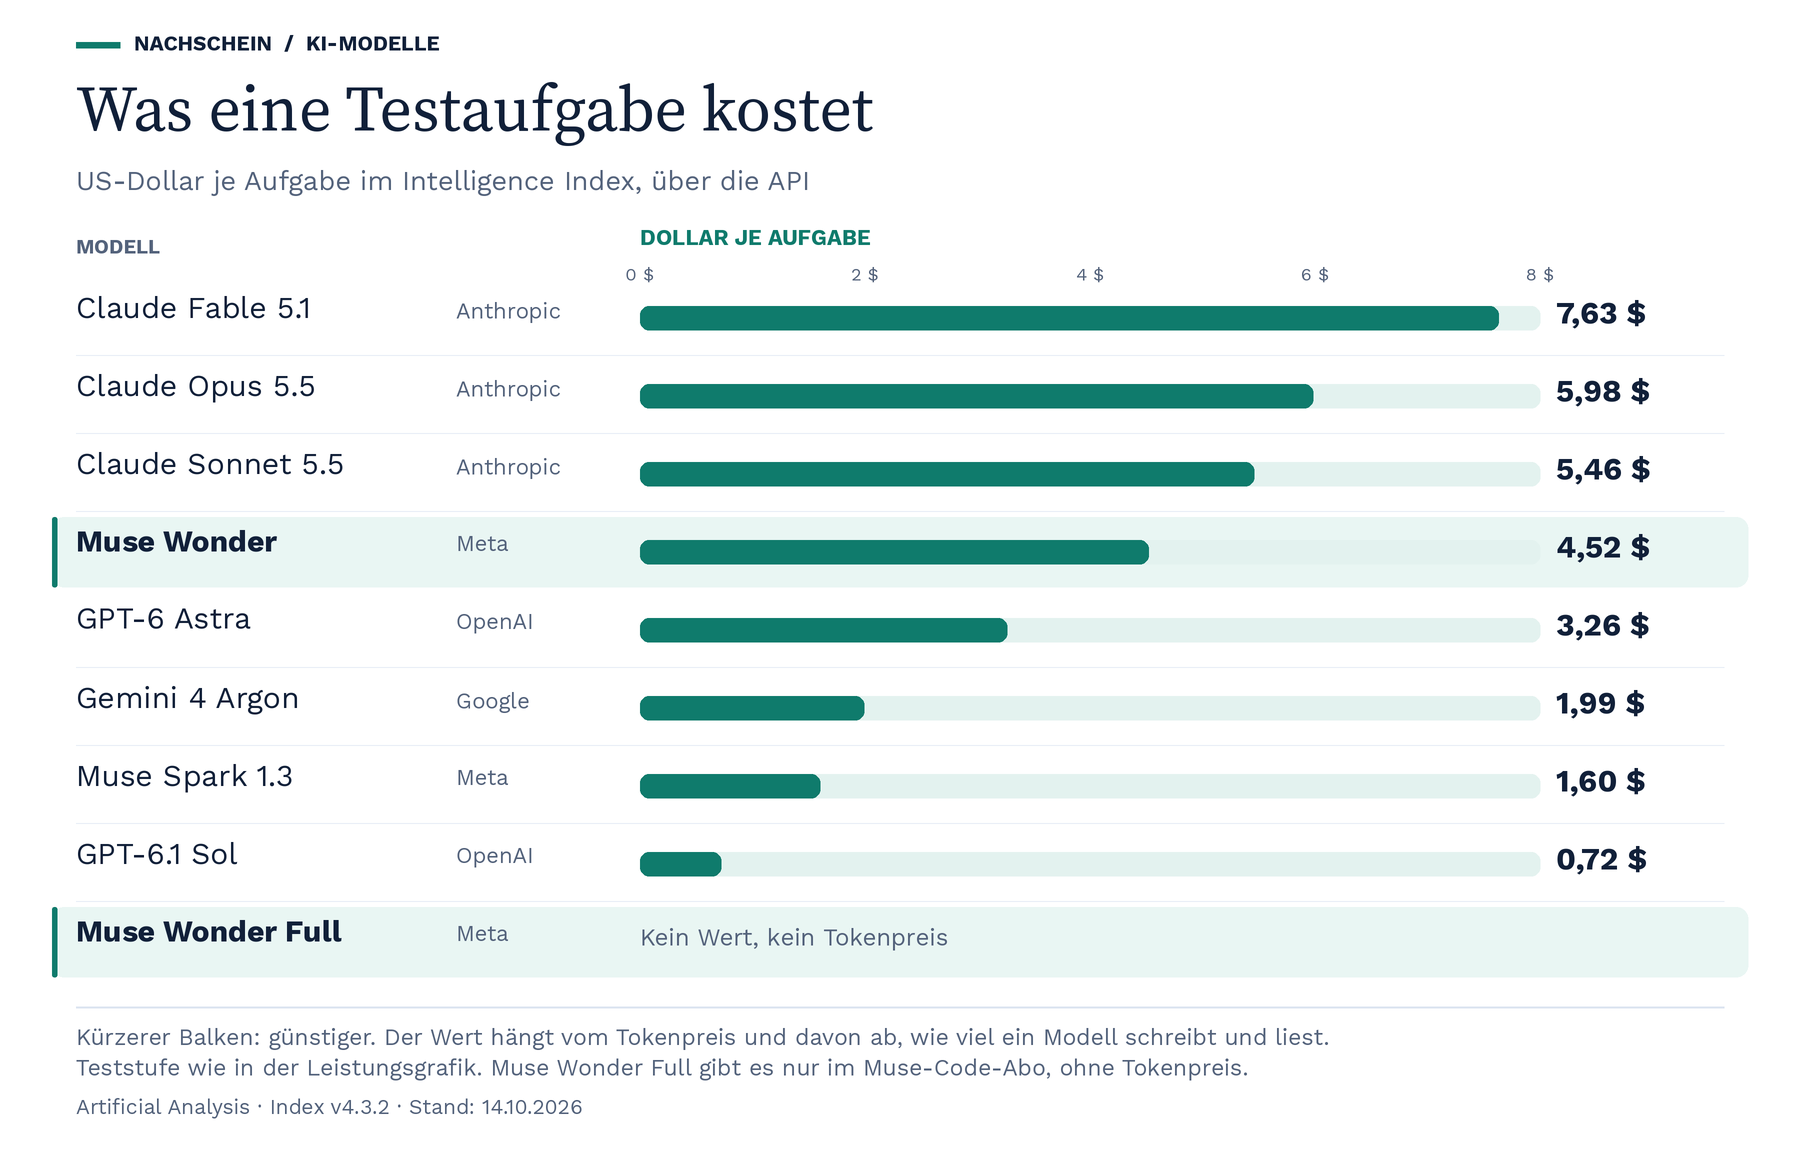
Muse Code gibt es laut Metas Produktseite in vier Abostufen für 5, 15, 50 und 200 Dollar im Monat. Wonder Full steckt erst ab der Stufe für 50 Dollar drin. Zu den Abos der Muse-App kursieren in der Presse verschiedene Zahlen. Eine Preisliste von Meta habe ich dafür nicht gefunden, deshalb lasse ich sie weg.
Ein erster Praxistest
Zwei Tage nach dem Start gibt es einen ersten ausführlichen Erfahrungsbericht, aber noch keine großen Testreihen. Kingy AI hat in Muse Code beide Modelle an drei kleinen Python-Projekten ausprobiert. Beide bestanden alle Prüfungen. Wonder Full brauchte aber deutlich länger, beim größten Projekt knapp 10 statt knapp 4 Minuten, und brachte laut Kingy in diesen Versuchen keinen Qualitätsgewinn. In einem zweiten Test mit vier Aufgaben in einem bestehenden Projekt schafften Muse Code mit Wonder Full und Claude Code mit Opus 5.5 alle Aufgaben ohne Nachhilfe. Muse Code brauchte dafür zusammen gut 26 Minuten, Claude Code knapp 9. Kingy schreibt selbst, dass vier Aufgaben keine allgemeine Rangfolge ergeben.
Und in Deutschland?
Die Muse-App ist seit September in den USA und seit Mitte September in Kanada erhältlich. In der EU gibt es sie nicht, und Meta hat keinen Starttermin genannt. Bei der Schnittstelle sieht es anders aus. Seit dem 12. Oktober ist Muse Wonder beim Zwischenhändler OpenRouter gelistet, mit Meta als einzigem Anbieter und zu denselben Preisen. Eine Ländereinschränkung nennt OpenRouter nicht. Auch Vercel bietet das Modell über sein AI Gateway an. Ob Metas eigene Model API aus Deutschland erreichbar ist, sagt Meta in der Ankündigung nicht. Ausprobiert habe ich OpenRouter und Vercel nicht. Nach diesen Angaben müsste sich Muse Wonder aus Deutschland auch ohne die App testen lassen.
Unterm Strich
Wunder oder Wundertüte? Nach den unabhängigen Messungen von Artificial Analysis ist Wonder Full ein starkes Modell, aber kein überlegenes. Es liegt knapp hinter Opus 5.5, schwächelt beim Faktenwissen und ist nur im Abo zu haben. Muse Wonder hat denselben Listenpreis wie Opus 5.5, ist je Testaufgabe rund ein Viertel günstiger, liegt im Index von Artificial Analysis aber sechs Punkte dahinter. Wie gut Meta Muse Wonder im Alltag arbeitet, zeigt sich erst in weiteren unabhängigen Tests.
Quellen
18 Links
- Meta: Introducing Muse Wonder and Muse Wonder Full: Frontier Models for Agents (12. Oktober 2026, aktualisiert 13. Oktober 2026)
- Meta AI Research: Blogbeitrag zu Muse Wonder
- Meta AI Research: Model Card zu Muse Wonder
- Artificial Analysis: Auswertung zu Muse Wonder und Muse Wonder Full
- Artificial Analysis: Messwerte zu Muse Wonder
- Artificial Analysis: Modellvergleich (abgerufen am 14. Oktober 2026)
- TechCrunch: Meta releases its first frontier model, Muse Wonder (12. Oktober 2026)
- Decrypt: Meta's New Muse Wonder Finally Puts Zuckerberg in the Frontier AI Race (12. Oktober 2026)
- Notebookcheck: Meta Muse Wonder: Developers get it now, the Muse app skips Europe (13. Oktober 2026)
- Notebookcheck: Meta Muse kommt aufs iPad, nach Deutschland aber weiterhin nicht (8. Oktober 2026)
- iPhone in Canada: Meta's Muse AI Agent Is Now Available in Canada (18. September 2026)
- Campus Technology: Meta Releases Muse Glimmer, an Open-Weight AI Model Designed to Run on Consumer Hardware (26. August 2026)
- Meta: Muse Code, Produktseite mit Abostufen (abgerufen am 14. Oktober 2026)
- Gabriel Anhaia (DEV Community): Meta's Muse Wonder Costs Exactly What Opus 5.5 Costs. It Loses 9 of Meta's Own 14 Benchmarks (12. Oktober 2026)
- Kingy AI: Is Muse Wonder Full Worth $50 a Month? Real Tasks, Usage Limits and Finished Projects (12. Oktober 2026)
- OpenRouter: Muse Wonder (abgerufen am 14. Oktober 2026)
- Vercel: Muse Wonder now available on AI Gateway (12. Oktober 2026)
- Axios: Meta debuts Muse Spark, first AI model under Alexandr Wang (8. April 2026)
Stand der Recherche und der Quellen: 14.10.2026. Ich habe Muse Wonder nicht selbst getestet. Messwerte, Preise und Verfügbarkeit können sich schnell ändern.
Alle Angaben erfolgen nach bestem Wissen und ohne Gewähr. Für Richtigkeit, Vollständigkeit und Aktualität übernehme ich, soweit gesetzlich zulässig, keine Haftung.
Welche KI-Werkzeuge passen zu deinem Filmprojekt?
Schick mir Produkt, Einsatz und Zeitraum. Ich sage dir persönlich, welche Modelle für dein Vorhaben sinnvoll sind und wo sie an Grenzen stoßen.