
Die Nachricht
Das Oktober-Update soll Aufgaben mit weniger Text lösen
DeepSeek hat V4.1 Flash am 10. September veröffentlicht und am 17. Oktober die Version 1017 nachgelegt. Laut offizieller Ankündigung läuft das Update bereits auf der Website, in der App und über die API. Das ist die Schnittstelle, über die andere Programme auf das Modell zugreifen.
Der Schwerpunkt liegt auf Programmierung und sogenannten KI-Agenten. Damit sind KI-Systeme gemeint, die mehrere Arbeitsschritte ausführen: zum Beispiel Dateien untersuchen, Programmcode schreiben und das Ergebnis prüfen. DeepSeek berichtet von besseren Testergebnissen und kürzerer Bearbeitungszeit. Außerdem soll das Modell weniger Text für seinen Lösungsweg und die Antwort erzeugen. Das kann Zeit und Kosten sparen.
Die Modellbeschreibung zu 1017 nennt unter anderem diese Ergebnisse aus DeepSeeks eigenen Tests. Die kurzen Erklärungen neben den Testnamen helfen bei der Einordnung:
| Test und Aufgabe | Bisherige Version | Update 1017 |
|---|---|---|
| Humanity’s Last Exam Schwierige Wissens- und Denkaufgaben, ohne zusätzliche Werkzeuge | 36,8 | 42,6 |
| Terminal-Bench 4.0 Aufgaben in einer Computer-Kommandozeile | 31,2 | 42,3 |
| DeepSWE v1.1 Arbeit an Softwareprojekten | 74,2 | 77,0 |
| ProgramBench Programmieraufgaben | 20,3 | 29,1 |
Die Zahlen zeigen Verbesserungen in den jeweiligen Tests. Sie lassen sich aber nicht zu einem gemeinsamen Ergebnis zusammenzählen. Und sie stammen vom Hersteller, nicht aus einer unabhängigen Prüfung.
Einzelheiten zu DeepSeeks Tests
Quelle: Modellbeschreibung von 1017. Bei Humanity’s Last Exam stehen hier die Ergebnisse des vollständigen Tests. Für die reine Text-Teilmenge nennt DeepSeek 39,1 und 44,0. Bei Terminal-Bench verwendet der Hersteller Claude Code als Agenten-Umgebung, bei DeepSWE Mini-SWE-V2. Testumgebung und erlaubter Denkaufwand beeinflussen die Ergebnisse.
Wo DeepSeek zwischen Haiku, Sonnet und Opus steht
Artificial Analysis prüft KI-Modelle unabhängig von den Herstellern. Sein „Intelligence Index“ fasst zehn unterschiedliche Tests zu einer Punktzahl zusammen. Mehr Punkte bedeuten ein besseres Gesamtergebnis in diesem Testsatz. Die Punkte sind keine Prozentangabe und keine Garantie für jede einzelne Aufgabe.
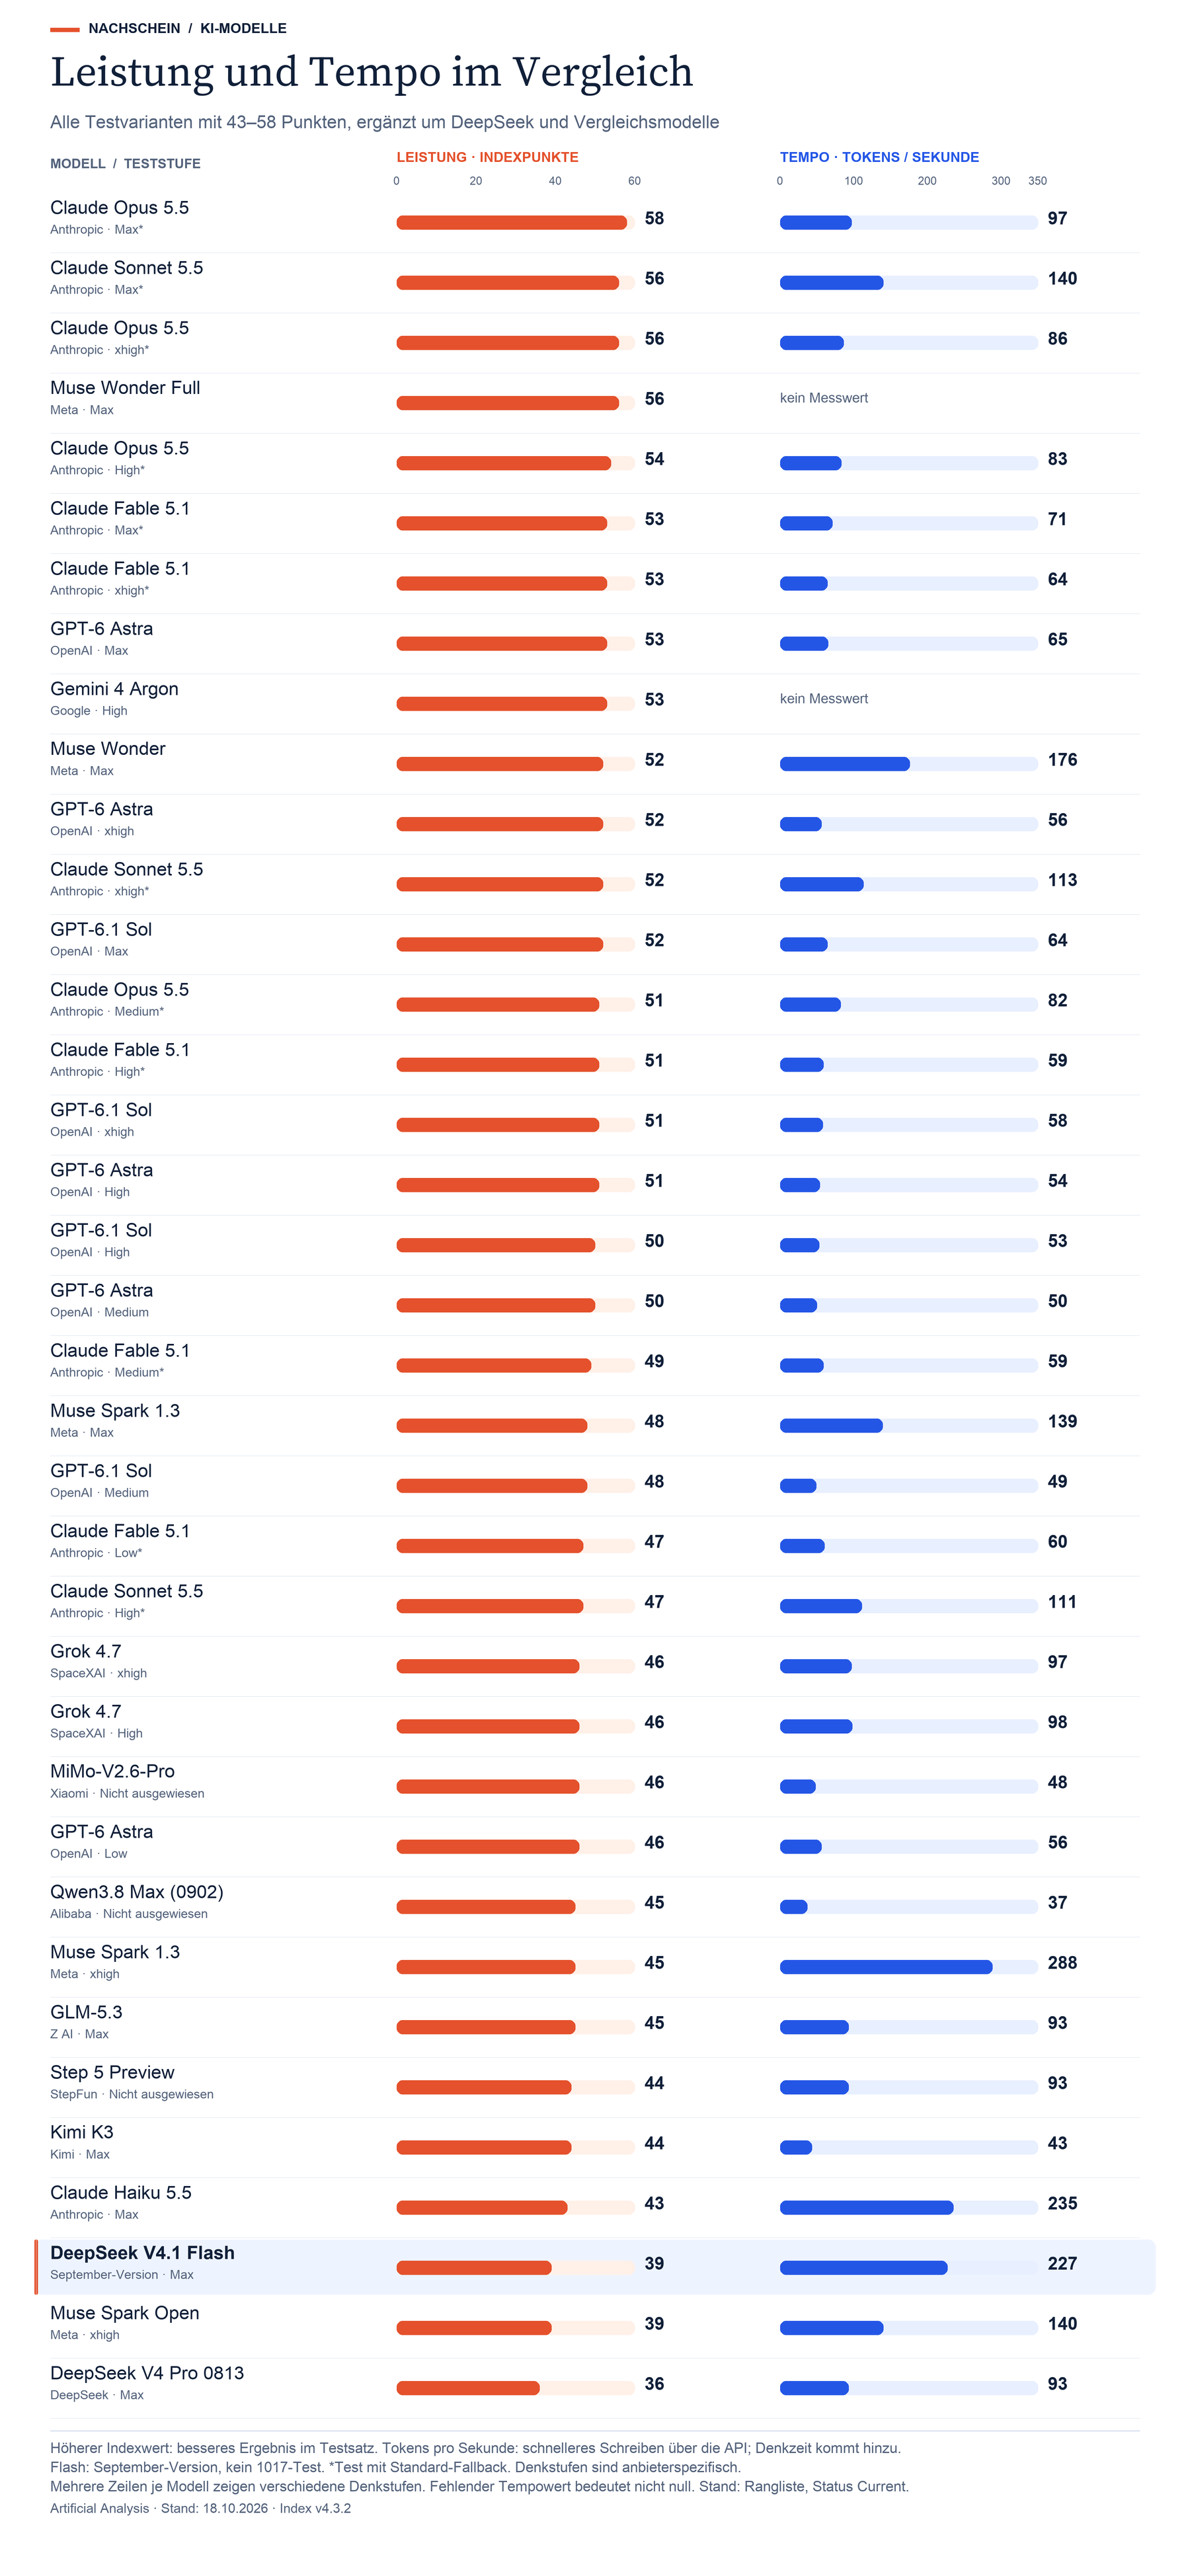
DeepSeek V4.1 Flash erreicht dort 39 Punkte. Das liegt unter Claude Haiku 5.5 mit 43 Punkten und deutlich unter den Spitzenwerten: Claude Sonnet 5.5 kommt auf 56, Claude Opus 5.5 auf 58 Punkte. Die folgende Grafik zeigt alle 34 in der aktuellen Rangliste aufgeführten Testvarianten zwischen 43 und 58 Punkten. Darunter stehen DeepSeek und zwei weitere Modelle zum Vergleich. Der Bereich von 40 bis 42 Punkten ist hier nicht abgebildet.
Mehrere Zeilen mit demselben Modellnamen zeigen verschiedene Denkstufen. Diese Einstellung bestimmt, wie viel Aufwand das Modell für den Lösungsweg betreiben darf. Sie kann das Ergebnis, die Wartezeit und die Kosten verändern. Haiku steht in dieser Übersicht also nicht an der Spitze. Es ist eines der Vergleichsmodelle.
Wichtig beim DeepSeek-Wert: Die abrufbare Modellseite beschreibt weiterhin die September-Version auf der Denkstufe Max. Ein separates unabhängiges Ergebnis für das neue Update 1017 ließ sich am 18. Oktober nicht verifizieren. DeepSeeks neue Herstellerwerte dürfen deshalb nicht auf die 39 Punkte aufgeschlagen werden.
Quellen und Messung der vollständigen Vergleichsgruppe
Quelle: Artificial Analysis: Modellrangliste, abgerufen am 18.10.2026, Status „Current“, Intelligence Index v4.3.2. Enthalten sind alle 34 Zeilen mit 43 bis 58 Punkten sowie DeepSeek V4.1 Flash Max, Muse Spark Open xhigh und DeepSeek V4 Pro 0813 Max. Die Grafik übernimmt Punkte, gerundetes Ausgabetempo und Teststufen aus derselben Ranglistenansicht. Denkstufen sind je Anbieter verschieden. Ein Stern kennzeichnet die von Artificial Analysis als „with fallback“ bezeichneten Tests mit Standard-Fallback. Fehlende Tempowerte sind keine Nullwerte: Für Muse Wonder Full gibt es keine öffentliche API; bei Gemini 4 Argon enthält die Rangliste keinen Tempowert. Modellseiten und Anbieteransichten können andere laufend aktualisierte Tempowerte zeigen.
Die Tests prüfen überwiegend englischsprachige, textbasierte Aufgaben. Sie beantworten daher nicht automatisch, wie gut ein Modell deutsche Texte schreibt oder Bilder erkennt. Auch ein Modell mit niedrigerem Gesamtwert kann bei einer bestimmten Aufgabe gut passen. Mehr zum Meta-Vergleichsmodell steht im Artikel über Muse Spark Open.
Schnellere Textausgabe ist noch keine schneller erledigte Aufgabe
Die blaue Spalte der Grafik zeigt, wie schnell ein Modell Text ausgibt. Gemessen wird in Tokens pro Sekunde. Tokens sind kleine Textstücke, etwa ein Wort oder ein Teil davon. Die ganze Wartezeit ist damit noch nicht erfasst: Das Modell muss die Anfrage verarbeiten, seinen Lösungsweg entwickeln und gegebenenfalls Werkzeuge aufrufen.
DeepSeek Flash erreicht im verwendeten Ranglistenstand rund 227 Tokens pro Sekunde. Das ältere V4 Pro 0813 kommt auf rund 93, Haiku 5.5 auf rund 235. Flash schreibt damit deutlich schneller als das ältere Pro-Modell. Eine lange Ausgabe oder zusätzliche Versuche können diesen Vorteil bei der fertigen Aufgabe wieder verkleinern.
Warum die Tempowerte schwanken
Die Grafik verwendet einheitlich die Ranglistenansicht vom 18.10.2026. Die Anbietervergleichsseite für Flash zeigte beim vorherigen Abruf dagegen rund 176 Tokens pro Sekunde für DeepSeeks API. Anbieter, Messansicht und Zeitpunkt beeinflussen das Ergebnis. Keiner dieser Werte ist eine getrennte unabhängige Tempomessung des Updates 1017.
Was DeepSeek günstiger machen soll
DeepSeek verarbeitet Eingaben und Antworten mit unterschiedlich großem Rechenaufwand. Außerdem speichert es benötigte Zwischenergebnisse platzsparender als beim Vorgänger V4 Flash. Das soll den Betrieb günstiger machen. Die technischen Angaben stammen bereits aus der September-Veröffentlichung; sie sind keine neu eingeführten Funktionen des Oktober-Updates.
Auch die Denkstufe verändert den Aufwand. Die API-Dokumentation bietet low, high und max an, also niedrigen, hohen und maximalen Denkaufwand. Voreingestellt ist high. Die Grafik zeigt DeepSeek dagegen auf Max. Sie beschreibt deshalb nicht automatisch das Verhalten mit der Standardeinstellung.
Technischer Hintergrund zu Rechenaufwand und Speicher
Laut DeepSeek verwendet V4.1 Flash eine asymmetrische Encoder-Decoder-Architektur: Für die Eingabeverarbeitung werden acht Milliarden Parameter aktiviert, für die Ausgabe 16 Milliarden. Parameter sind die im Modell gespeicherten Rechenwerte. Der KV-Cache, ein Zwischenspeicher für die weitere Textverarbeitung, soll gegenüber V4 Flash nur ein Viertel des schnellen HBM-Speichers und ein Achtel des SSD-Speichers benötigen. Das sind Angaben zu bestimmten Speicherbereichen. Sie belegen keinen entsprechend niedrigeren Gesamtstromverbrauch und keine pauschale Ersparnis für Anwender. Quelle: DeepSeek, September-Ankündigung.
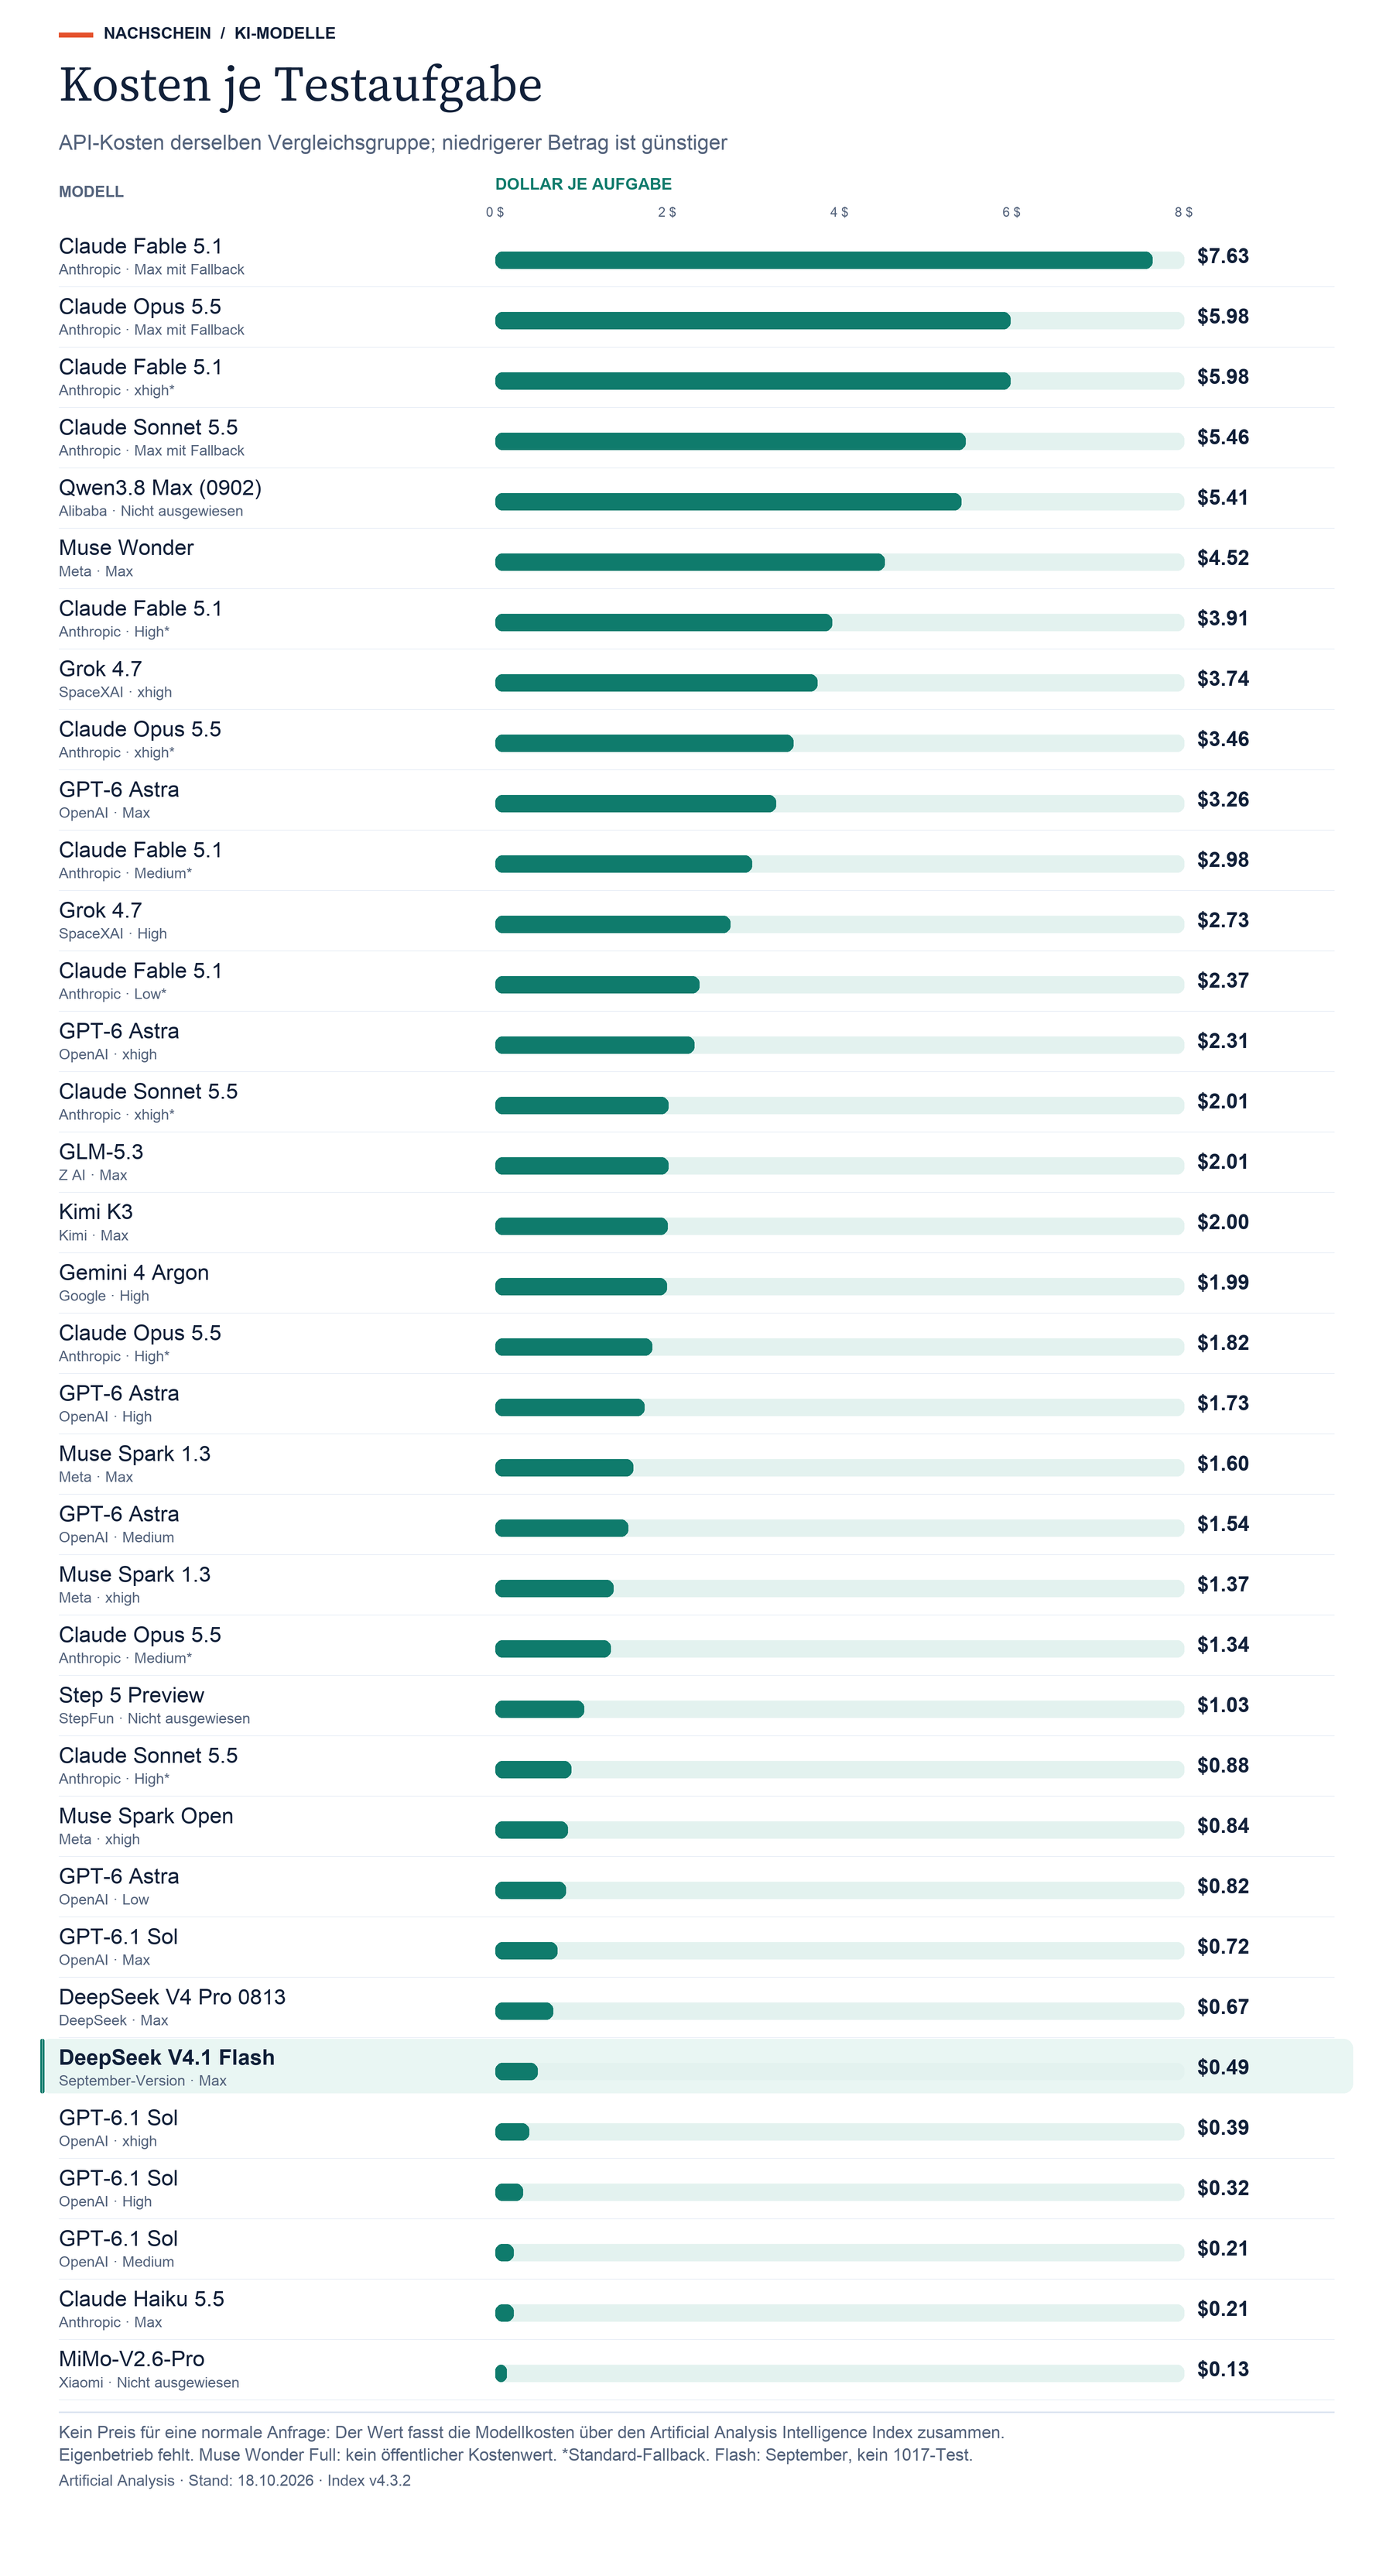
Für Anwender zählt am Ende, was eine erledigte Aufgabe kostet. Die zweite Grafik zeigt die durchschnittlichen API-Kosten je Aufgabe im Testsatz von Artificial Analysis. Sie verwendet dieselbe Vergleichsgruppe wie die Leistungsgrafik. Niedrigere Beträge bedeuten hier geringere Kosten, nicht bessere Testergebnisse.
Was diese Kosten einschließen
Quelle: Artificial Analysis: Modellrangliste, Abruf 18.10.2026. Die Kosten je Aufgabe sind ein gewichteter Durchschnitt über den Intelligence Index. Darin stecken unter anderem Eingaben, wiederverwendete Eingaben sowie Text für Lösungsweg und Antwort. Das ist kein Preis für eine gewöhnliche Chat-Anfrage. Eigene Hardware und Eigenbetrieb sind nicht enthalten. Für Muse Wonder Full fehlt ein öffentlicher Kostenwert; diese Zeile entfällt deshalb in der Kostengrafik. DeepSeek Flash bezeichnet weiterhin die September-Version.
Flash liegt bei 0,49 US-Dollar pro Testaufgabe, das ältere V4 Pro 0813 bei 0,67. Haiku 5.5 kommt mit 0,21 US-Dollar günstiger weg und erreicht zugleich mehr Punkte. Die stärkeren Modelle sind nicht alle teurer: Auch ihre Denkstufen verändern die Kosten erheblich. Die beiden Grafiken sollten deshalb zusammen gelesen werden.
Mit 1017 verspricht DeepSeek weniger ausgegebenen Text bei besseren Ergebnissen. Wie viel das außerhalb der Hersteller-Tests spart, bleibt offen. Billige Textausgabe hilft wenig, wenn eine Aufgabe mehrfach versucht oder anschließend lange von Hand korrigiert werden muss.
Zugang und aktuelle API-Preise
Das neue Modell ist auf DeepSeeks Website und in der App verfügbar. Wer es in ein eigenes Programm einbinden möchte, verwendet über die API den Modellnamen deepseek-flash. Die Dokumentation ordnet diesem Namen ausdrücklich die Version 1017 zu.
Für die API wird nach Textmenge abgerechnet. Die Preisliste unterscheidet Haupt- und Nebenzeiten. Bereits verarbeitete Eingaben können bei erneuter Verwendung günstiger sein. Das heißt in der Tabelle „Cache-Treffer“.
| Abrechnung | Hauptzeit Peak | Nebenzeit Off-Peak |
|---|---|---|
| Neue Eingabe | 0,30 $ | 0,15 $ |
| Wiederverwendete Eingabe Cache-Treffer | 0,006 $ | 0,003 $ |
| Ausgabe | 1,20 $ | 0,60 $ |
Ein Rechenbeispiel: Eine Million neue Eingabe-Tokens und eine Million Ausgabe-Tokens kosten zusammen 1,50 US-Dollar zur Hauptzeit oder 0,75 US-Dollar zur Nebenzeit. Diese Menge verteilt sich über mehrere Anfragen. Sie beschreibt weder eine einzelne typische Chat-Anfrage noch die Kosten eines fertigen Projekts. Weitere Dienste können zusätzliche Gebühren verursachen.
Genaue Zeitfenster und ältere Modellnamen
Hauptzeiten gelten laut Preistabelle montags bis freitags von 01:00 bis 04:00 Uhr und von 06:00 bis 10:00 Uhr UTC, ausgenommen chinesische Feiertage. Die übrige Zeit einschließlich der Wochenenden ist Nebenzeit. Die alten API-Namen deepseek-v4-flash und deepseek-v4-flash-vision-exp werden weiterhin angenommen, führen laut aktueller Dokumentation aber ebenfalls zu 1017.
Das Modell nimmt Text und Bilder entgegen und gibt Text aus. Es kann außerdem Werkzeuge aufrufen, die ihm ein Programm bereitstellt. Sein Kontextfenster fasst eine Million Tokens. Das ist der Textumfang, den es in einer Anfrage einschließlich der Antwort verarbeiten kann, kein Versprechen, dass jedes Detail daraus zuverlässig berücksichtigt wird.
Die Modelldateien von 1017 stehen unter MIT-Lizenz zum Download bereit und ermöglichen den Betrieb auf eigener Hardware. Die hier gezeigten Tempowerte stammen jedoch aus API-Tests. Sie sagen nicht, wie schnell das Modell auf einem eigenen Rechner läuft.
Für wen ein Vergleich sinnvoll ist
V4.1 Flash ist vor allem für Teams interessant, die KI in Programme einbauen oder mehrstufige Aufgaben automatisieren möchten. Für ihre Entscheidung zählen die Kosten pro erfolgreich erledigter Aufgabe und der Aufwand für Nacharbeit. Wer hauptsächlich im Browser Fragen stellt oder Texte schreibt, sollte stattdessen prüfen, welches Angebot die eigenen Aufgaben gut und verständlich löst.
Das Oktober-Update verspricht Fortschritte beim Programmieren. Ob es im Alltag tatsächlich Zeit und Geld spart, müssen unabhängige Tests von 1017 und Versuche mit den eigenen Aufgaben zeigen.
Quellen
13 Links
- Artificial Analysis: vollständige Modellrangliste, Stand 18.10.2026
- DeepSeek: Denkstufen und Standardeinstellung
- DeepSeek: Ankündigung des Updates 1017, 17. Oktober 2026
- DeepSeek: V4.1-Flash-Veröffentlichung, 10. September 2026
- DeepSeek: Modellkarte, Benchmarks und MIT-Lizenz für 1017
- DeepSeek: API-Modellnamen und Zuordnung
- DeepSeek: API-Preise und Zeitfenster
- Artificial Analysis: V4.1 Flash Max, September-Version
- Artificial Analysis: API-Anbieter für V4.1 Flash
- Artificial Analysis: V4 Pro 0813 Max
- Artificial Analysis: Claude Haiku 5.5 Max
- Artificial Analysis: Muse Spark Open xhigh
- Artificial Analysis: Methodik des Intelligence Index
Stand der Recherche: 18.10.2026. DeepSeek V4.1 Flash und 1017 wurden nicht selbst getestet. Herstellerangaben und unabhängige Messungen sind im Text getrennt. Preise und API-Tempo können sich ändern.
Alle Angaben erfolgen nach bestem Wissen und ohne Gewähr. Für Richtigkeit, Vollständigkeit und Aktualität übernehme ich, soweit gesetzlich zulässig, keine Haftung.
Du planst einen Film für deine Marke?
Schick mir Produkt, Einsatz und Zeitraum. Ich entwickle das Konzept und produziere deinen Werbefilm, Imagefilm oder deine Social Ads bis zum fertigen Schnitt.