
Die Nachricht
Inception hat Mercury 3 am 19. Oktober 2026 vorgestellt. Das neue Sprachmodell soll mit GPT-6 Luna und Claude Haiku 5.5 mithalten und dabei deutlich schneller Text ausgeben. Der Anbieter nennt 1.068 Tokens pro Sekunde auf NVIDIA-Grafikprozessoren. Ein Token ist ein kleines Textstück, etwa ein Wort oder ein Teil davon. Die Zahl beschreibt das Tempo beim Schreiben, nicht die gesamte Wartezeit auf eine Antwort. Inceptions Ankündigung
Wie Mercury Textblöcke schrittweise verfeinert
Viele bekannte Sprachmodelle erzeugen Text nacheinander: Aus der Anfrage und dem bisherigen Text berechnen sie jeweils das nächste Token. So wächst die Antwort Stück für Stück.
Mercury nutzt Text-Diffusion. Dabei werden mehrere Stellen in einem zunächst unfertigen Textblock parallel überarbeitet. Anschaulich lässt sich das mit einem Absatz vergleichen, in dem anfangs noch viele Stellen unklar sind. Über mehrere Durchgänge entsteht daraus lesbarer Text. Das ist eine vereinfachte Beschreibung des Rechenverfahrens.
Die Dokumentation zur Textausgabe beschreibt ausdrücklich eine blockweise Ausgabe. Nutzer sehen bereits verfeinerte Textstücke; die gesamte Antwort erscheint also nicht zwingend auf einmal. Optional kann eine Anwendung auch die Zwischenstände anzeigen. Dann lässt sich verfolgen, wie sich der Text während der Verarbeitung verändert.
Inceptions Tests sehen Mercury achtmal vor beiden Konkurrenten
Inceptions Tabelle umfasst zwölf Tests. Mercury 3 liegt darin zehnmal vor GPT-6 Luna und zehnmal vor Claude Haiku 5.5. In acht Tests liegt es vor beiden zugleich. Alle drei Modelle wurden auf der Denkstufe „medium“ verglichen. Diese Stufen bestimmen, wie viel Aufwand ein Modell für die Lösung einer Aufgabe betreibt; gleich benannte Stufen verschiedener Anbieter sind aber keine identischen Rechenbudgets.
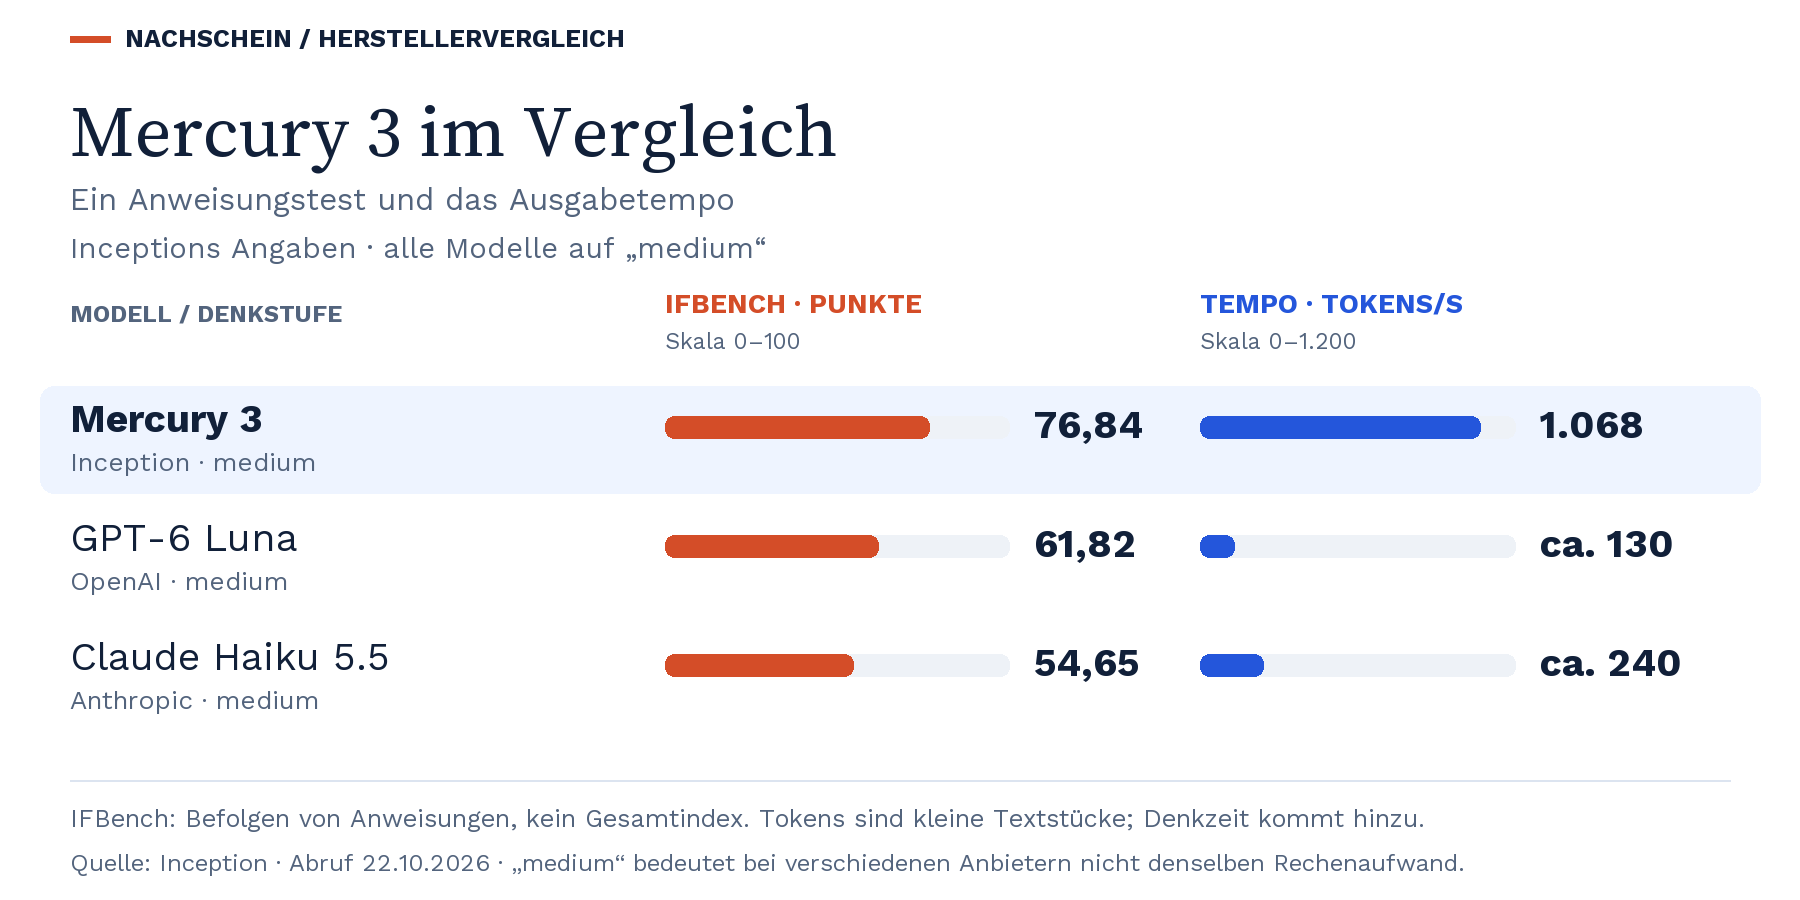
Ein deutlicher Vorsprung zeigt sich bei IFBench, einem Test für das Befolgen von Anweisungen. Mercury 3 erreicht 76,84 Punkte, GPT-6 Luna 61,82 und Haiku 5.5 54,65. Im Programmiertest SWE-Bench Atlas nennt Inception 51,08 Punkte für Mercury, gegenüber 33,33 für Luna und 32,26 für Haiku. Das sind Ergebnisse aus Inceptions eigener Vergleichstabelle.
Teststufen und Grenzen des Vergleichs
Die Grafik übernimmt die Werte aus Inceptions Mercury-3-Vergleichstabelle. Die ungefähren Tempowerte für Luna und Haiku sind dort mit einem Näherungszeichen versehen. IFBench ist ein einzelner Test, kein übergreifender Leistungsindex. Die Denkstufe „medium“ ist nicht zwingend der Standard im jeweiligen Chat und bedeutet bei verschiedenen Anbietern nicht denselben Rechenaufwand. Zum Tempo nennt der Blogpost NVIDIA-GPUs, aber keine vollständig reproduzierbaren Messbedingungen. Das Ausgabetempo erfasst nicht allein die Wartezeit bis zur vollständigen Antwort. Die OpenRouter-Messung im folgenden Abschnitt ist eine andere Datenquelle und wurde deshalb nicht in diese Balken eingemischt.
Bei anderen Aufgaben dreht sich die Reihenfolge um. Haiku liegt in DeepSWE, einem weiteren Programmiertest, und beim Wiederfinden von Informationen im langen Kontext in MRCR v2 vorn. Luna führt knapp bei AA-Omniscience-Public, das Faktenwissen prüft, und bei AA-LCR v1.1 für das Schlussfolgern über lange Texte.
Die Tabelle zeigt ein in dieser Vergleichsgruppe konkurrenzfähiges Modell. Einen allgemeinen Sieg über GPT oder Claude belegt sie nicht. Auch die Tests mit „AA“ im Namen stammen hier aus der Herstellertabelle, eine unabhängige Prüfung von Mercury 3 durch Artificial Analysis folgt daraus nicht.
1.068 Tokens pro Sekunde sind keine Zusage für jede Anfrage
Inception wirbt mit vier- bis achtfachem Ausgabetempo gegenüber den beiden Vergleichsmodellen. Angaben etwa zum genauen GPU-Typ und zur Zahl gleichzeitig verarbeiteter Anfragen fehlen in der Ankündigung. Ohne diese Bedingungen lässt sich der Wert nicht einfach auf den eigenen Chat übertragen.
Ein anderer Blick kommt von OpenRouter. Die Plattform vermittelt den Zugang zu verschiedenen Modellen und misst laufenden Datenverkehr. Am 22. Oktober zeigte sie für Mercury 3 einen als P50 ausgewiesenen Durchsatz von 224 Tokens pro Sekunde. P50 bezeichnet den Median, also den mittleren Wert der sortierten Messungen. Die Anzeige war nicht nach Denkstufe gefiltert. OpenRouter zählt beim Durchsatz sowohl Tokens für den Lösungsweg als auch Ausgabe-Tokens. Erläuterung der Messung Das ist keine Messung unter denselben Bedingungen wie bei Inception und widerlegt den Herstellerwert allein nicht. Der Unterschied zeigt, wie stark das gemessene Tempo von den jeweiligen Bedingungen abhängen kann.
Zur Gesamtwartezeit gehört außerdem die Verarbeitung der Eingabe und gegebenenfalls ein Lösungsweg vor der sichtbaren Antwort. Eine schnell geschriebene Antwort spart wenig Zeit, wenn danach viel korrigiert werden muss.
Mercury gibt es im Chat und über eine Schnittstelle
Zum Ausprobieren verlinkt Inception auf Mercury Chat. Wer das Modell in eigene Software einbauen möchte, kann Inceptions API nutzen. Eine API ist eine Schnittstelle, über die Programme Anfragen an das Modell senden. Laut Ankündigung gibt es Mercury 3 außerdem bei OpenRouter, Baseten und Vercel.
Die Modellübersicht von Inception nennt ein Kontextfenster von einer Million Tokens. Es bestimmt, wie viel Text das Modell innerhalb einer Anfrage berücksichtigen kann. Diese Kapazität ist keine Garantie, dass es jedes Detail langer Unterlagen zuverlässig findet. Mercury 3 verarbeitet Text und antwortet mit Text. Es unterstützt außerdem Werkzeugaufrufe und Ergebnisse in einem festgelegten Datenformat. Bilder versteht oder erzeugt es laut Modellübersicht nicht: Dort ist als Format nur Text aufgeführt.
Zum Start halbiert Inception die API-Preise
Über Inceptions direkte API kostet eine Million Eingabe-Tokens regulär 0,20 US-Dollar. Eine Million Ausgabe-Tokens kostet 0,70 Dollar. Mit dem derzeitigen Einführungsrabatt sinken die Beträge auf 0,10 und 0,35 Dollar. Ein Enddatum nennt die Preisseite zum Recherchezeitpunkt nicht.
Eine Million neue Eingabe-Tokens und eine Million Ausgabe-Tokens kosten zum Einführungspreis zusammen 0,45 Dollar, regulär 0,90 Dollar. Das ist ein Rechenbeispiel für eine Textmenge, kein Preis für eine typische Chat-Anfrage. Über andere Plattformen können andere Konditionen gelten.
Ein Sprachmodell mit Text-Diffusion erreicht nach den Herstellerwerten die Leistung bekannter schneller Modelle. Wie oft daraus im Alltag eine bessere oder früher brauchbare Antwort wird, lassen diese Zahlen offen.
Quellen
5 Links
Stand der Recherche: 22.10.2026. Mercury 3 wurde für diesen Artikel nicht selbst getestet. Die Leistungswerte stammen von Inception, die gesondert genannten Durchsatzwerte von OpenRouter. Preise und laufende Messwerte können sich ändern.
Alle Angaben erfolgen nach bestem Wissen und ohne Gewähr. Für Richtigkeit, Vollständigkeit und Aktualität übernehme ich, soweit gesetzlich zulässig, keine Haftung.
Du planst einen Film für deine Marke?
Schick mir Produkt, Einsatz und Zeitraum. Ich entwickle das Konzept und produziere deinen Werbefilm, Imagefilm oder deine Social Ads bis zum fertigen Schnitt.