
Die Nachricht
Was ist MiniMax M3.1 Flash?
MiniMax ist ein KI-Unternehmen aus Shanghai und seit Januar 2026 an der Börse in Hongkong notiert. Hierzulande kennt man die Firma vor allem durch Hailuo, eine Plattform für KI-Videos. Daneben entwickelt MiniMax Sprachmodelle, also KI, die Texte liest und schreibt. M3.1 Flash gehört dazu. MiniMax hat es am 19. Oktober 2026 offiziell vorgestellt.
Bei MiniMax bezeichnet Flash die schnelle, sparsame Variante. Ein stärkeres Pro-Modell ist angekündigt, einen Termin nennt MiniMax nicht. Gedacht ist M3.1 Flash vor allem für KI-Agenten. Das sind Programme, die eine Aufgabe in vielen Schritten selbst abarbeiten, zum Beispiel Code schreiben und testen oder andere Programme und Webseiten bedienen. Laut Artificial Analysis nimmt das Modell Text und Bilder an und antwortet mit Text. Einige Fachmedien nennen zusätzlich Video als Eingabe. Pro Anfrage verarbeitet es bis zu eine Million Tokens. Ein Token ist ein kleines Textstück, etwa ein Wort oder ein Teil davon.
Ganz neu ist das Modell nicht. Eine Vorabversion steckte seit Ende September im Programmierwerkzeug MiniMax Code. Außerdem lief eine frühe Fassung auf der Plattform OpenRouter unter dem Decknamen Space Bunny, ohne dass offiziell bekannt war, wer dahintersteckt. Laut Unite.ai stand Space Bunny dort zehn Tage lang auf Platz 1. Nach Angaben von OpenRouter wurden dabei 56,7 Billionen Tokens verarbeitet, MiniMax spricht von mehr als 200 Billionen.
Kann ich das Modell selbst nutzen?
MiniMax bietet M3.1 Flash über seine API an. Über diese Schnittstelle können andere Programme auf das Modell zugreifen.
Ausprobieren lässt sich das Modell auch über OpenRouter. Der Dienst bündelt viele KI-Modelle unter einem Konto. Dort ist M3.1 Flash zum Start kostenlos. Laut Unite.ai gilt das 72 Stunden lang, danach greifen dieselben Preise wie bei MiniMax. Die Anfragen gehen direkt an MiniMax, eine Verarbeitung innerhalb der EU bietet OpenRouter für dieses Modell nicht an. Wer Kunden- oder Firmendaten eingibt, sollte das vorher klären.
Für den Betrieb auf eigener Hardware sind die angekündigten Gewichte nötig. Gewichte nennt man die Modelldatei, die man für den Betrieb auf eigener Hardware braucht. Wie MarkTechPost unter Berufung auf MiniMax berichtet, hat das Modell 428 Milliarden Parameter, von denen pro Anfrage etwa 23 Milliarden aktiv sind (von MiniMax bislang nicht bestätigt). Parameter sind die gespeicherten Zahlenwerte eines Modells. Welche Hardware für M3.1 Flash tatsächlich nötig ist, lässt sich vor der Veröffentlichung der Modelldateien und einer bestätigten Modellgröße noch nicht verlässlich beurteilen.
Was MiniMax verspricht
Laut MiniMax arbeitet M3.1 Flash fast dreimal so schnell wie der Vorgänger. Bei Agenten-Aufgaben sollen die Gesamtkosten um 70 Prozent sinken. Im normalen Einsatz soll das Modell mehr als 200 Tokens pro Sekunde ausgeben, im Median mehr als 170.
Dazu veröffentlicht MiniMax eigene Testergebnisse. Im BankerToolBench, der typische Aufgaben aus dem Investmentbanking prüft, kommt das Modell auf 76,2 Punkte. VentureBeat berichtet, das liege auf Höhe von Claude Opus 5. Im Programmiertest DeepSWE erreicht es 73,7 Prozent. In derselben Herstellertabelle liegen Claude Opus 5 mit 74 Prozent knapp und DeepSeek V4.1 Flash mit 77 Prozent etwas deutlicher davor. Im Test OSWorld V2, bei dem ein Modell einen Computer bedient, nennt MiniMax 61,7 Punkte. Das sind alles Herstellerangaben, unabhängig geprüft wurden sie nicht.
Was unabhängige Tests zeigen
Artificial Analysis prüft KI-Modelle unabhängig von den Herstellern. Der Intelligence Index des Dienstes fasst zehn Tests zu einer Punktzahl zusammen. Je mehr Punkte, desto besser das Gesamtergebnis in diesem Testsatz. Zum Start wurde M3.1 Flash mit 42 Punkten geführt, der Vorgänger M3 kam auf 29. Die aktuelle Rangliste zeigt für M3.1 Flash inzwischen 43 Punkte. Die folgende Grafik zeigt den früheren Messstand mit 42 Punkten. Laut VentureBeat liegen vergleichbare schnelle Modelle dicht beieinander. DeepSeek V4.1 Flash kommt in der Oktober-Fassung 1017 auf 45, GLM-5.3 Flash auf 42 und Gemini 3.8 Flash auf 41 Punkte. Im schweren Wissens- und Denktest Humanity’s Last Exam verbessert sich M3.1 Flash gegenüber M3 von 39 auf 48 Prozent.
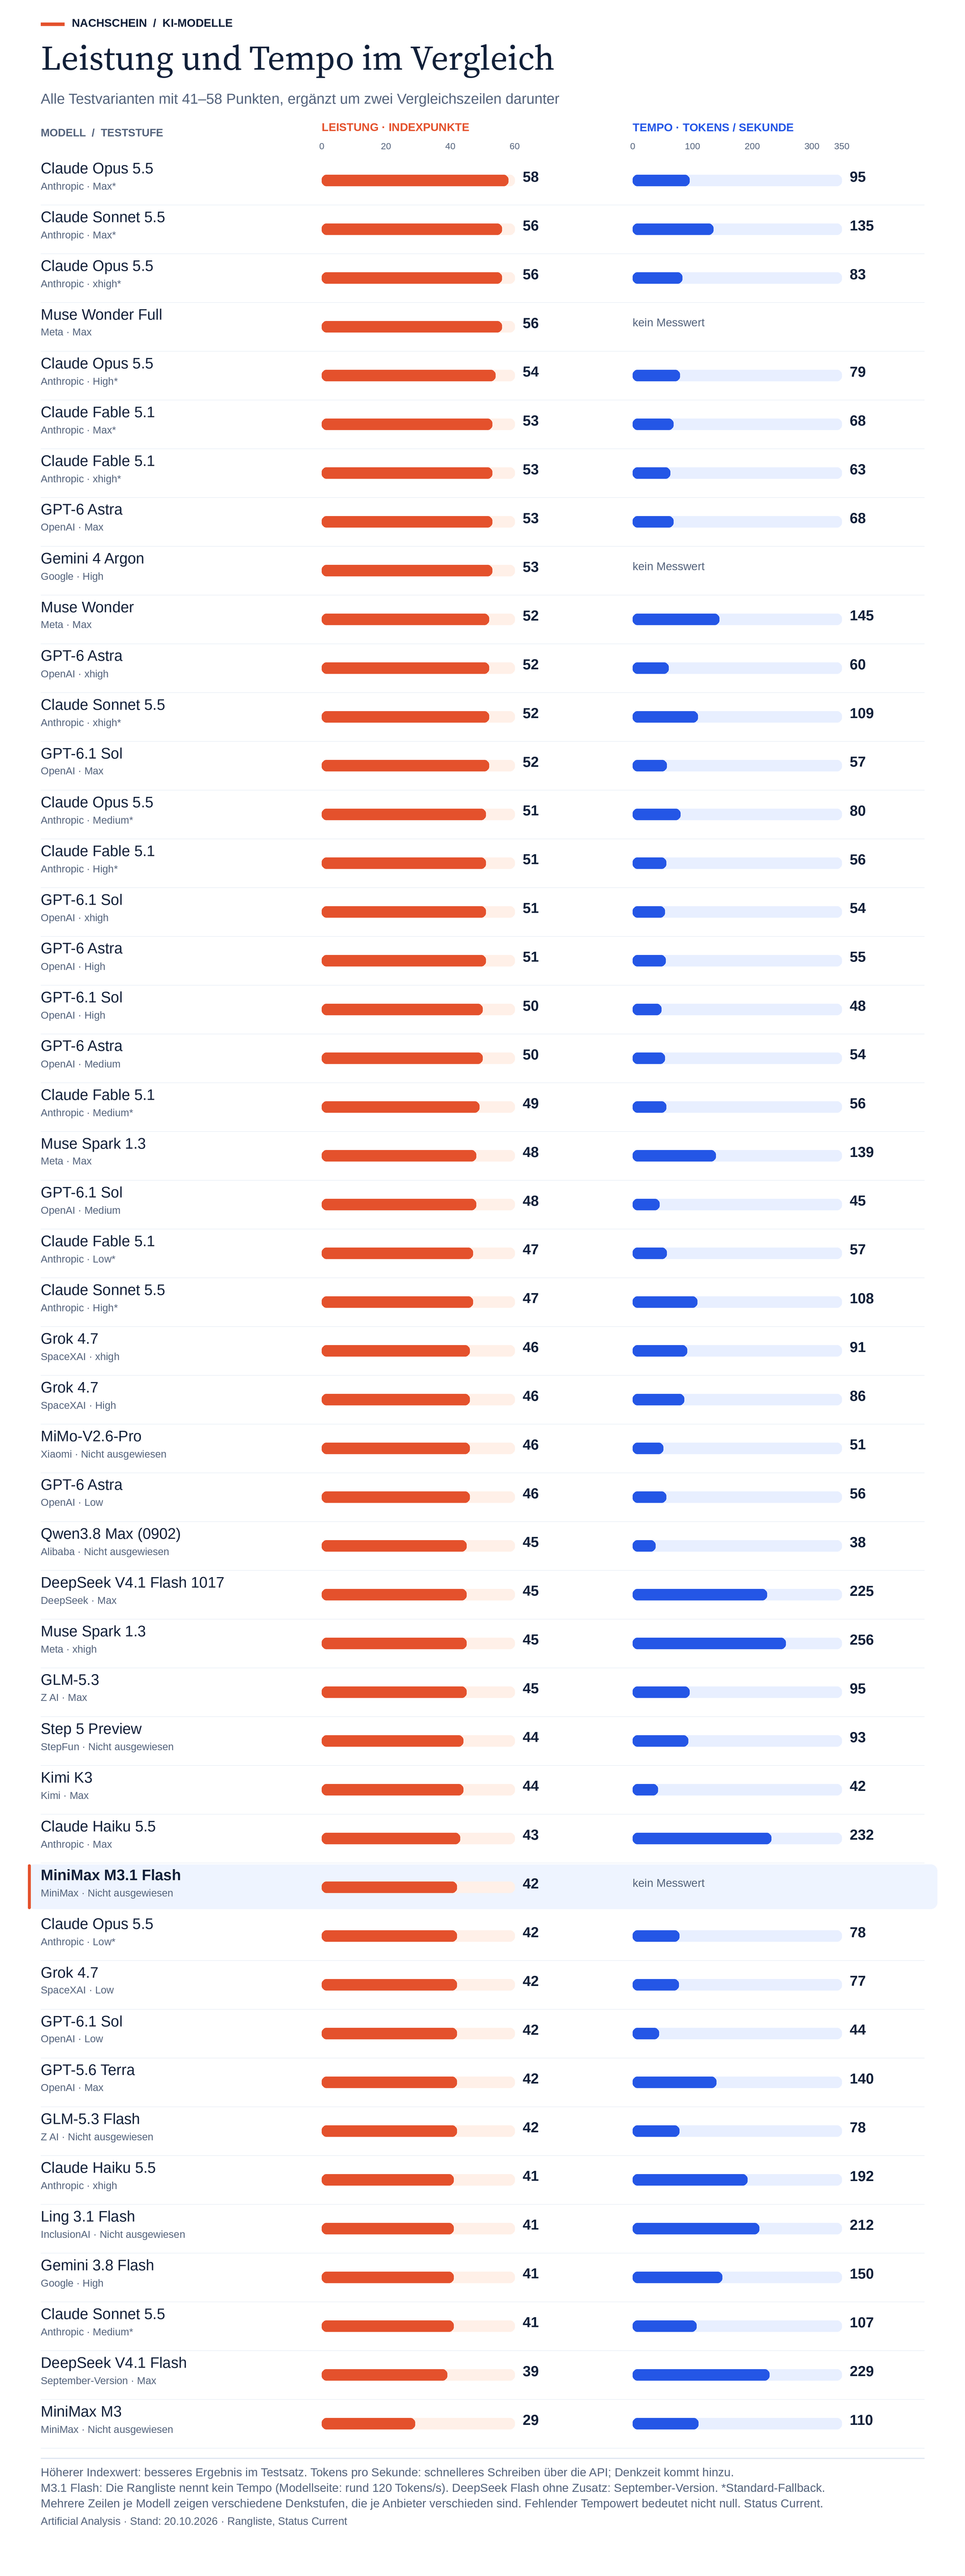
Quellen und Messung der vollständigen Vergleichsgruppe
Quelle: Artificial Analysis: Modellrangliste, abgerufen am 20.10.2026, Status „Current“. Enthalten sind alle Zeilen mit 41 bis 58 Punkten sowie DeepSeek V4.1 Flash Max (September-Version) und MiniMax M3 als Vergleich. Die Grafik übernimmt Punkte, gerundetes Ausgabetempo und Teststufen aus derselben Ranglistenansicht. Die Rangliste nennt keine Version des Index, deshalb steht hier keine. Denkstufen sind je Anbieter verschieden. Ein Stern kennzeichnet die von Artificial Analysis als „with fallback“ bezeichneten Tests mit Standard-Fallback. Fehlende Tempowerte sind keine Nullwerte: Für Muse Wonder Full gibt es keine öffentliche API; bei Gemini 4 Argon und MiniMax M3.1 Flash enthielt der für die Grafik verwendete Ranglistenstand keinen Tempowert. Die Modellseite von M3.1 Flash nennt inzwischen rund 105 Tokens pro Sekunde. Dieser aktuellere Wert ist in der Grafik nicht enthalten. Tempowerte ändern sich laufend.
Beim Preis pro Testaufgabe ist M3.1 Flash günstiger als DeepSeek V4.1 Flash 1017 und Gemini 3.8 Flash. Claude Haiku 5.5 auf der Denkstufe Max liegt mit 0,21 Dollar allerdings noch etwas darunter. Artificial Analysis misst rund 0,22 US-Dollar je Aufgabe aus seinem Index. Bei DeepSeek V4.1 Flash 1017 sind es laut VentureBeat rund 0,26 Dollar, bei Gemini 3.8 Flash 1,24 Dollar. M3 kostete noch rund 0,51 Dollar. Das sind etwa 57 Prozent weniger und damit weniger als die 70 Prozent, die MiniMax für Agenten-Aufgaben nennt. Gemessen wurde aber nicht dasselbe, die beiden Werte lassen sich nur grob vergleichen.
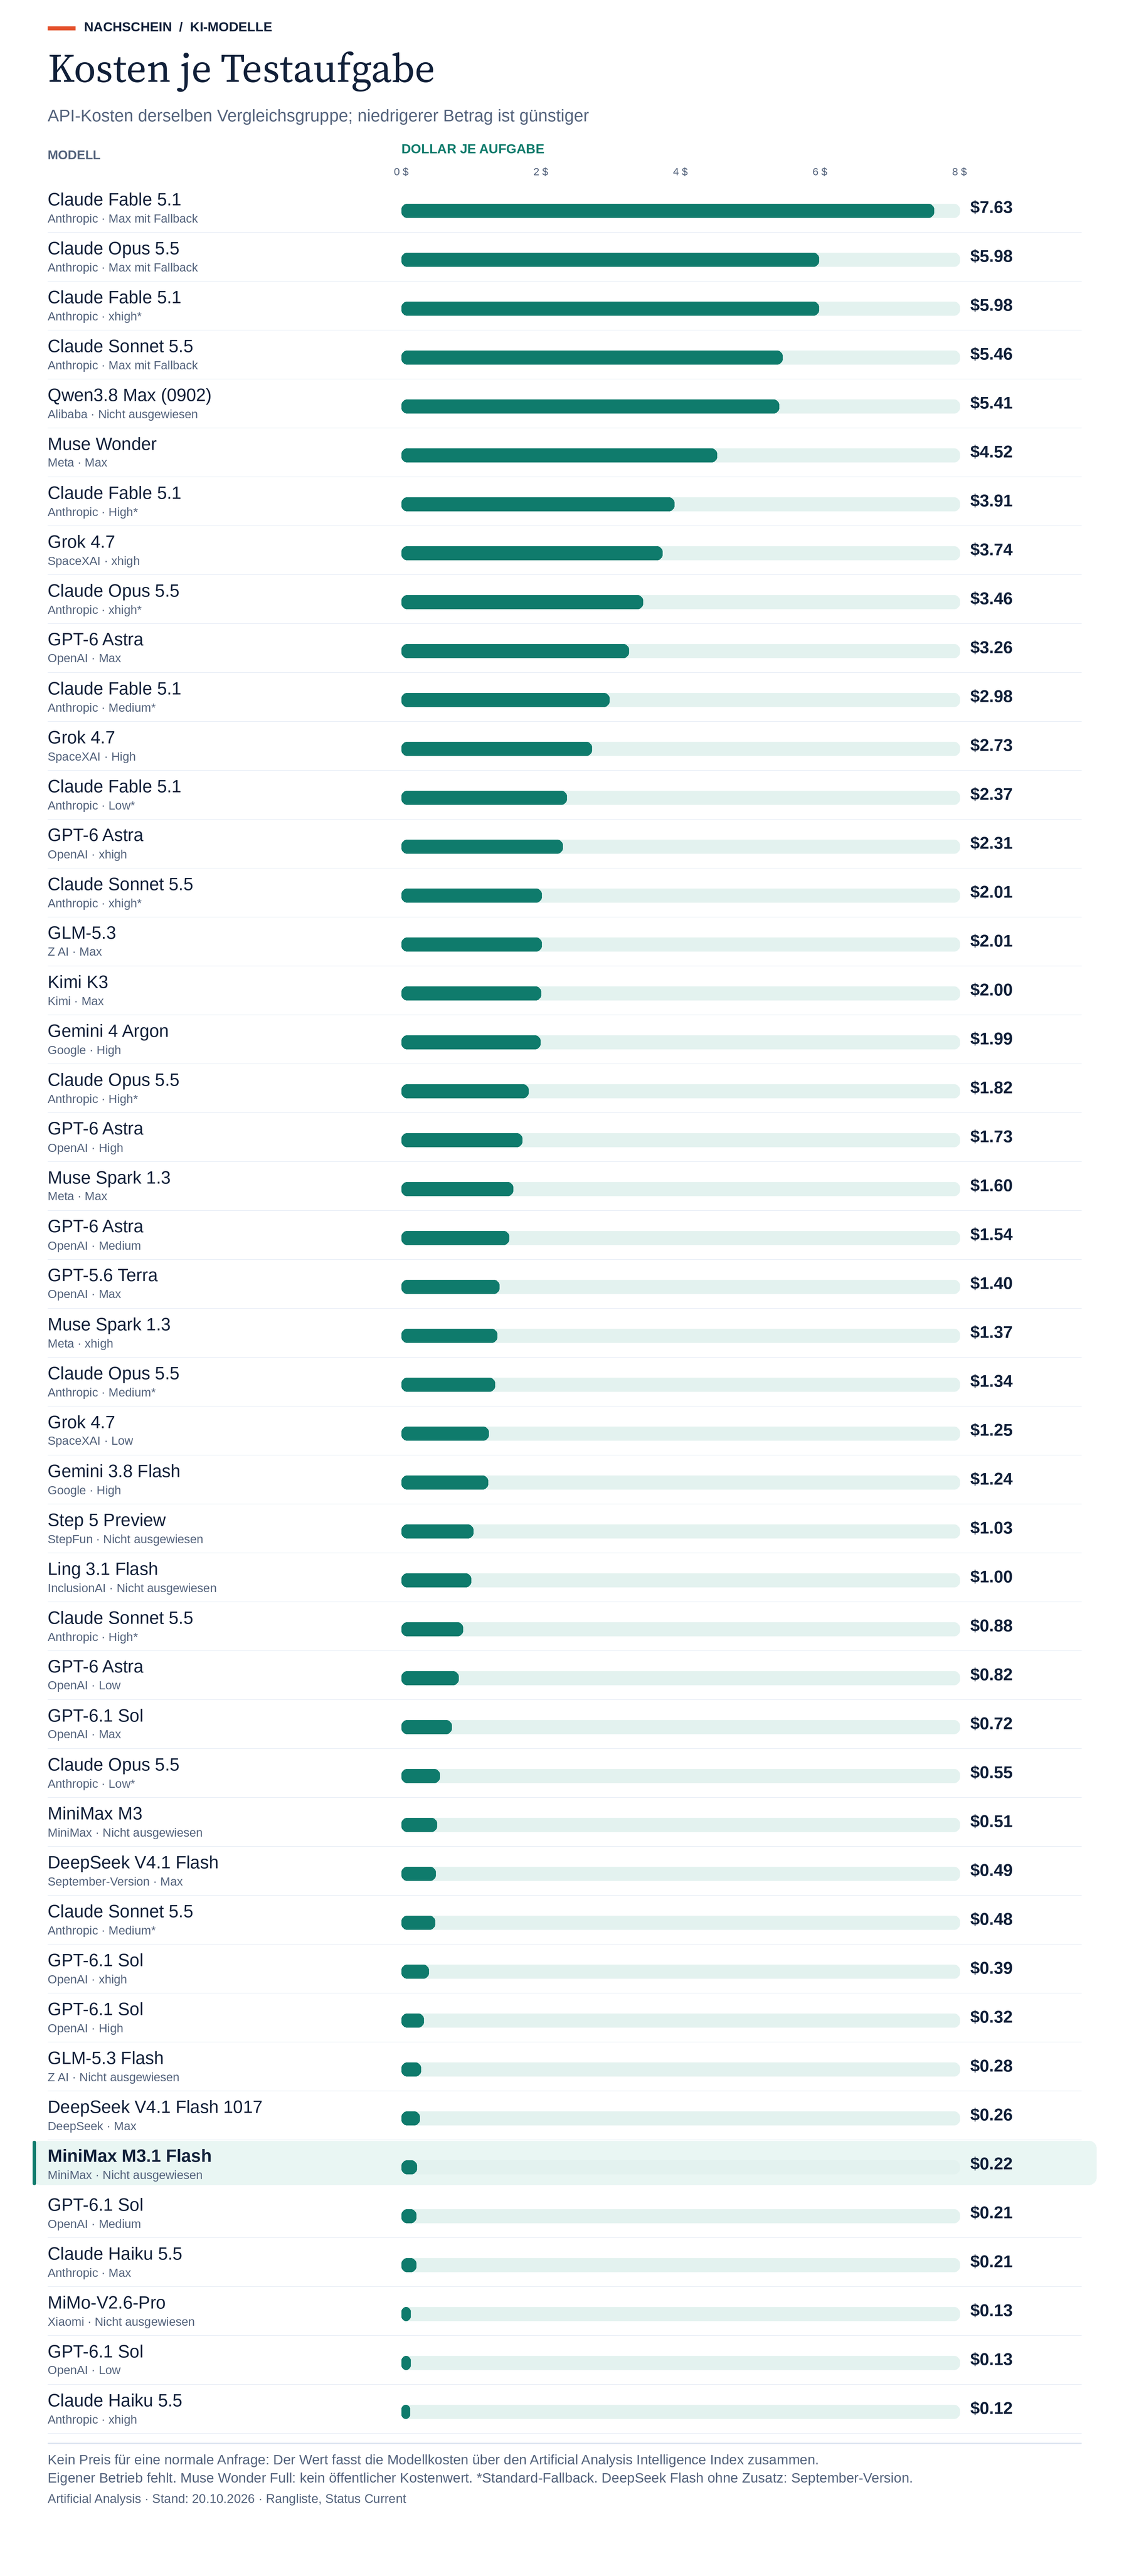
Was diese Kosten einschließen
Quelle: Artificial Analysis: Modellrangliste, Abruf 20.10.2026. Die Kosten je Aufgabe sind ein gewichteter Durchschnitt über den Intelligence Index. Darin stecken unter anderem Eingaben, wiederverwendete Eingaben sowie Text für Lösungsweg und Antwort. Das ist kein Preis für eine gewöhnliche Chat-Anfrage. Eigene Hardware und Eigenbetrieb sind nicht enthalten. Für Muse Wonder Full fehlt ein öffentlicher Kostenwert; diese Zeile entfällt deshalb in der Kostengrafik. DeepSeek V4.1 Flash ohne Zusatz bezeichnet die September-Version.
Wie viel Text ein Modell erzeugt, wirkt sich direkt auf die Kosten aus, denn jedes ausgegebene Token wird bezahlt. Für den gesamten Index brauchte M3.1 Flash laut dem früheren Messstand bei VentureBeat rund 189 Millionen Ausgabe-Tokens. Die aktuelle Modellseite von Artificial Analysis nennt inzwischen 180 Millionen. GLM-5.3 Flash und Gemini 3.8 Flash kamen auf jeweils über 320 Millionen.
Die größte Schwäche zeigt sich beim Faktenwissen. Von Halluzinieren spricht man, wenn ein Modell eine falsche Antwort selbstsicher ausgibt. Im Wissenstest AA-Omniscience beantwortet M3.1 Flash laut VentureBeat 56 Prozent der Fragen richtig, DeepSeek V4.1 Flash 43 Prozent. Weiß M3.1 Flash eine Antwort nicht, rät es dagegen fast immer. Laut VentureBeat beträgt die Halluzinationsrate 93 Prozent (in dieser Recherche nicht unabhängig nachgeprüft). Artificial Analysis betrachtet dafür alle Fälle, in denen ein Modell nicht richtig lag, und misst, wie oft es dann trotzdem falsch antwortete, statt zu passen. Wer das Modell für Recherchen nutzt, sollte Fakten immer gegenprüfen.
Beim Tempo misst Artificial Analysis weniger, als MiniMax angibt, nämlich aktuell rund 105 Tokens pro Sekunde über die API von MiniMax. Bis das erste Textstück erscheint, vergeht etwa eine Sekunde. OpenRouter zeigt auf seiner Modellseite noch niedrigere Werte. So kurz nach dem Start ändern sich solche Zahlen schnell.
Was kostet MiniMax M3.1 Flash?
Über die API kostet M3.1 Flash 0,15 US-Dollar pro Million Eingabe-Tokens und 0,60 Dollar pro Million Ausgabe-Tokens. Eingaben, die sich wiederholen und zwischengespeichert werden, kosten 0,015 Dollar pro Million. Eine Million Eingabe- und eine Million Ausgabe-Tokens kosten zusammen also 0,75 Dollar. Diese Menge verteilt sich auf viele Anfragen und sagt nichts über die Kosten eines fertigen Projekts. Wann sich ein günstiges Modell lohnt, habe ich im Artikel Welches KI-Modell lohnt sich für welche Aufgabe? beschrieben.
Was am 23. Oktober kommen soll
Zum Start gibt es die Gewichte von M3.1 Flash noch nicht. MiniMax schreibt in der Ankündigung nur, sie kämen später. Laut VentureBeat und weiteren Fachmedien plant MiniMax die Freigabe für den 23. Oktober 2026 (im verlinkten MiniMax-Blogbeitrag ist dieser Termin nicht bestätigt). Unter welcher Lizenz das passiert, ist noch nicht bekannt.
Für Nutzer in Europa ist die Lizenz der entscheidende Punkt. Beim Videomodell H3 hat MiniMax die EU, Großbritannien, Südkorea und die USA von der Lizenz für die offenen Gewichte ausgeschlossen. Beim Sprachmodell M3 dagegen erschienen die Gewichte kurz nach dem Start im Juni. Sobald Gewichte und Lizenz von M3.1 Flash vorliegen, aktualisiere ich diesen Artikel.
Unterm Strich
Nach den Messungen von Artificial Analysis ist M3.1 Flash deutlich besser als M3. In der aktuellen Rangliste liegt es mit 43 Punkten knapp vor GLM-5.3 Flash und hinter DeepSeek V4.1 Flash 1017. Pro Testaufgabe ist es günstiger als DeepSeek und Gemini 3.8 Flash; Haiku 5.5 auf Max kostet noch etwas weniger. Für Programmier- und Agenten-Aufgaben mit vielen Tokens kann sich das lohnen. Bei Wissensfragen würde ich jede Antwort gegenprüfen, denn das Modell rät bei Unsicherheit lieber, als zu passen.
Quellen
10 Links
- MiniMax: Ankündigung von M3.1 Flash, 19. Oktober 2026
- MiniMax: Release Notes der Modelle, abgerufen am 20.10.2026
- Artificial Analysis: MiniMax M3.1 Flash, abgerufen am 20.10.2026
- Artificial Analysis: Methodik von AA-Omniscience
- VentureBeat: MiniMax’s new M3.1 Flash beats DeepSeek and Opus 5 on a key business benchmark, 19. Oktober 2026
- Unite.ai: MiniMax Launches M3.1 Flash, Revealing Space Bunny Stealth Model, 19. Oktober 2026
- MarkTechPost: MiniMax M3.1 Flash, Modellgröße und Denkstufen, 19. Oktober 2026
- OpenRouter: MiniMax M3.1 Flash, abgerufen am 20.10.2026
- Hermes AI: Vorabversion in MiniMax Code, 27. September 2026
- NYU Shanghai RITS: Lizenz von MiniMax H3 schließt EU und USA aus
Alle Angaben erfolgen nach bestem Wissen und ohne Gewähr. Für Richtigkeit, Vollständigkeit und Aktualität übernehme ich, soweit gesetzlich zulässig, keine Haftung.
Stand der Recherche: 20.10.2026. M3.1 Flash habe ich nicht selbst getestet. Herstellerangaben und unabhängige Messungen sind im Text getrennt. Preise und Messwerte können sich schnell ändern.
Du planst einen Film für deine Marke?
Schick mir Produkt, Einsatz und Zeitraum. Ich entwickle das Konzept und produziere deinen Werbefilm, Imagefilm oder deine Social Ads bis zum fertigen Schnitt.